요약
[](https://www.nhncloud.com/kr) ## 들어가며 AI 코딩 에이전트에게 일을 시키면서, 저는 에이전트가 코드를 작성하는 과정을 계속 지켜보고 있었습니다. 파일이 수정되는 걸 보고, 빌드 로그를 확인하고, 에이전트의 판단이 맞는지 중간중간 개입했습니다. 병렬로 여러 작업을 돌리면 생산성이 올라갈 거라 기대했지만, 실제로는 에이전트 하나하나의 실행 과정을 따라가느라 개발자인 제가 병목이 되고 있었습니다. 여러 시행착오를 거치면서, 에이전트가 일하는 과정이 아니라 돌아오는 **산출물만 검토해도 충분하다**는 것을 깨닫게 됐습니다. 과정을 보던 시절에는 에이전트 3개를 동시에 돌리는 것이 한계였지만, 산출물만 보기 시작하자 그 이상도 감당할 수 있게 됐습니다. 다만 이 전환은 태도만 바꾼다고 되지 않았습니다. 산출물의 정의, 자동화된 테스트, 그리고 에이전트를 조율하는 운용 구조가 함께 있어야 했습니다. 이 글은 그 전환의 과정과 이를 뒷받침하는 구조를 공유합니다.## 과정을 보면 과정에 개입하게 된다 에이전트에게 "주문 알림 기능을 만들어 줘"라고 시키고 나면, 자연스럽게 궁금해졌습니다. 지금 뭘 하고 있지? 방향이 맞나? 에이전트가 파일을 수정하는 모습이 보이면 더 참기 어려웠습니다. "저 파일이 아니라 이 파일을 수정해야 하는데" — 이런 생각이 드는 순간 이미 개입하고 있었습니다. 개입 자체가 나쁜 것은 아닙니다. 문제는 개입이 **스케일하지 않는다**는 점이었습니다. 에이전트 하나의 과정을 지켜보면서 개입하는 건 가능합니다. 하지만 에이전트가 셋, 다섯으로 늘어나면 이야기가 달라집니다. 병렬로 돌리겠다고 만들어 놓고, 정작 저는 하나씩 순차적으로 들여다보고 있었습니다. 과정을 보는 한 병렬은 불가능했습니다. 한 가지 더 불편한 사실을 깨달았습니다. 과정을 보면서 개입해도, 그것이 결과의 품질을 보장하지 않았습니다. 에이전트가 코드를 작성하는 중간 과정을 아무리 꼼꼼히 지켜봐도, 최종적으로 그 코드가 의도한 대로 동작하는지는 **실행해 봐야** 알 수 있었습니다. 중간 과정 관찰에 쏟은 시간이 결과 검증을 대체하지 못했습니다. 그렇다면 과정을 보지 않고도 결과를 신뢰할 수 있는 구조를 만들 수는 없을까? 이 질문이 이 글에서 공유하려는 것들의 출발점이었습니다.
## Artifact Driven Development 이 경험에 이름을 붙이자면, Artifact Driven Development — AI 에이전트의 실행 **과정** 대신, 에이전트가 만들어 낸 **산출물**을 보고 판단하는 개발 방식입니다. 제가 검토하게 된 산출물은 세 가지였습니다. * **Plan**: 구현 전에 "무엇을, 어떻게, 어떤 파일을 수정해서" 만들 것인지를 정리한 문서입니다. Plan을 읽고 방향이 맞는지 판단합니다. Plan이 승인되면 에이전트는 그 범위 안에서 구현을 진행합니다. * **Test Case 결과**: 구현이 끝난 후 — 혹은 구현과 동시에 — 에이전트가 미리 정의된 테스트를 실행한 결과입니다. 중간 수정 과정을 추적하는 것보다, 사전에 정의된 TC를 통과했는지가 훨씬 나은 판단 기준이었습니다. * **Code**: 최종 코드 변경입니다. Plan의 범위 안에서, TC를 통과한 코드. diff를 리뷰합니다. 세 산출물은 각각 다른 질문에 답합니다. Plan은 "무엇을 만들 것인가", Test Case는 "무엇을 만족해야 완료인가", Code는 "실제로 무엇이 바뀌었는가". 이 세 가지는 자연스럽게 파이프라인을 이루었습니다.  제 관여 지점은 파이프라인의 **앞과 뒤**뿐이었습니다. 앞에서 Plan을 검토하고, 뒤에서 결과를 검토합니다. 가운데의 실행은 에이전트에게 맡겼습니다. 이 구조가 잡히자 에이전트가 몇 개든 병렬로 돌릴 수 있게 됐습니다. 완료된 산출물을 순서대로 검토하면 되니까요.
## Plan — 뭘 만들 건지 Plan은 에이전트가 작업을 시작하기 전에 함께 작성하는 구현 명세입니다. 무엇을 만들어야 하는지, 어떤 제약 조건이 있는지, 어떤 파일을 수정해야 하는지를 구조화된 텍스트로 정리했습니다. Plan은 AI의 자율성을 유지하면서도 방향을 제약하는 장치이고, 에이전트가 Plan 범위 밖으로 나가지 않도록 경계를 제공합니다. ### 맥락 복구 메커니즘 Plan에는 또 다른 역할이 있었습니다. AI 에이전트의 기억은 세션이 끝나면 사라집니다. 대화 맥락, 논의 과정, 결정 사항 — 이 모든 것은 세션이 닫히는 순간 휘발됩니다. 영구적으로 남는 것은 파일뿐입니다. 세션이 길어질수록, 에이전트가 초반에 파악한 정보는 희석되고 후반으로 갈수록 판단의 질이 떨어졌습니다. 그래서 세션 기억에 의존하지 않기로 했습니다. 매번 새 세션으로 시작하되, 그 세션이 필요한 모든 맥락을 파일에서 읽어오도록 설계했습니다. 이 관점에서 Plan은 단순한 문서가 아니었습니다. **맥락 복구 메커니즘**이었습니다. Plan만 잘 쓰여 있으면 누구든 — 사람이든 AI든 — 이어서 작업할 수 있습니다. 세션이 끊기더라도, Plan을 읽는 것만으로 새 에이전트는 이전 에이전트가 어디까지 무엇을 고려하며 진행했는지를 그대로 이어받을 수 있었습니다. ``` # Plan: #43 주문 상태 변경 알림 ## 개요 주문 상태 변경 시 사용자에게 알림을 발송한다. SMS, 이메일, 앱 푸시를 지원하며, 사용자별 설정에 따라 선택적 발송. ## 설계 결정 - 이벤트 기반 비동기 처리(주문 트랜잭션과 분리) - 채널별 Strategy 패턴(NotificationChannel 인터페이스) - 실패 시 최대 3회 재시도 ## 구현 항목 1. [ ] NotificationType enum — domain/notification/model/code/ 2. [ ] Notification 엔티티 — domain/notification/model/ 3. [ ] OrderStatusChangedEvent — domain/order/event/ 4. [ ] NotificationEventListener — @TransactionalEventListener 5. [ ] 채널 구현체 — Sms, Email, Push 6. [ ] 알림 설정 API — GET/PUT /users/{id}/notification-preferences ## 완료 기준 - TC-001 ~ TC-010 전부 통과 ``` Plan 템플릿을 고정하자 에이전트가 처음 읽는 정보의 형식이 항상 동일해졌고, 누락 없이 작업 맥락을 파악하는 데 걸리는 시간이 줄어들었습니다. 같은 Plan을 주면 어떤 에이전트든 유사한 결과로 수렴했습니다. 입력을 고정하니 출력이 예측 가능해졌습니다.
## Test Case — 맞게 만들었는지 Plan이 **무엇을 만들지**를 고정했다면, Test Case(이하 TC)는 **맞게 만들었는지**를 고정했습니다. 에이전트가 "구현 완료"라고 보고할 때 TC가 없으면 에이전트는 스스로 완료 기준을 만들고, 스스로 통과시킵니다. 출제자와 응시자가 같은 셈입니다. 이 경우 결과의 신뢰도가 크게 낮아졌습니다. 그래서 TC를 구현과 별도의 단계에서 정의하는 완료 기준으로 두었습니다. Plan과 구현된 코드를 기반으로, **이 기능이 올바르게 동작한다**는 것을 검증하는 시나리오를 에이전트가 정의합니다. 사람이 직접 했어도 똑같이 했을 일 — 구현물을 보고 테스트해야 할 항목을 정리하는 것 — 을 에이전트가 대신하는 겁니다. ### TC 자동화 ``` ✓ TC-001 결제 완료 시 알림 생성 [critical] ├─ ✓ POST /api/v1/orders/42/pay 200 0.8s ├─ ✓ GET /api/v1/notifications?oid=42 200 0.3s └─ ✓ POLL {"status": "SENT"} 1.2s -- passed 2.3s ✗ TC-007 발송 실패 시 재시도 [high] ├─ ✓ POST /api/v1/orders/42/pay 200 0.5s ├─ ✓ GET /api/v1/notifications?oid=42 200 0.3s └─ ✗ POLL {"retryCount": 3} expect: {"retryCount": 3} actual: {"retryCount": 1} ────────────────────────────────── ✅ 8 passed ✗ 2 failed (80%) ``` TC가 있어도 수동으로 돌려야 한다면, 다시 과정에 끌려들어갑니다. 에이전트가 "구현 완료"라고 보고할 때마다 직접 테스트를 실행하고 결과를 확인해야 한다면, 그것은 과정을 보는 것과 다를 바 없었습니다. TC 자동화를 갖추자 흐름이 달라졌습니다. 에이전트는 구현이 끝나면 자동으로 TC를 실행하고, 실패하면 스스로 수정하고 다시 돌립니다. 전부 통과될 때까지 반복합니다. 제게 돌아오는 것은 "10/10 passed"라는 결과뿐입니다. 이 결과만 보고 다음 단계로 넘길지 판단하면 됐습니다. Plan이 입력을 고정하고, 자동화된 TC가 출력을 검증하면, 가운데의 실행 과정은 문자 그대로 블랙박스가 됩니다. 블랙박스 안을 들여다볼 필요가 없어졌습니다. ### TC는 구체적일수록 좋았다 TC를 단순한 체크리스트가 아니라, API 호출, 상태 폴링, DB 확인, 오류 시나리오까지 step 단위로 구조화된 시나리오로 만들었습니다. 입력값, 기대 출력, 경계 조건을 명시합니다. TC가 구체적일수록 에이전트의 구현 방향이 좁혀지고, 통과한 TC의 신뢰도가 높아졌습니다.
## 산출물만으로는 풀리지 않는 문제들 Plan, Test Case, Code — 산출물을 고정하는 것까지는 좋았습니다. 하지만 실제로 에이전트를 여러 개 돌리기 시작하자, 산출물의 품질과는 별개인 **운용의 문제**가 드러났습니다. **프롬프트 품질이 들쭉날쭉했습니다.** 같은 작업인데 그때그때 다르게 지시하고, 빠뜨리는 맥락이 생기고, 결과도 불안정했습니다. Plan이 아무리 잘 쓰여 있어도, 그걸 에이전트에게 전달하는 프롬프트가 매번 달라지면 결과도 달라졌습니다. **입력과 출력 사이의 시간 격차가 컸습니다.** Plan을 주고 에이전트가 구현을 끝낼 때까지 기다려야 합니다. 그 사이에 다른 에이전트의 결과가 들어오고, 또 다른 에이전트에게 새 작업을 줘야 합니다. 에이전트가 늘어날수록 이 비동기 흐름을 머릿속으로 추적하는 것이 어려워졌습니다. **전체 현황이 안 보였습니다.** 어떤 에이전트가 어디까지 진행됐는지, 다음에 내가 뭘 해야 하는지가 흩어져 있었습니다. 산출물은 잘 정의되어 있는데, 그 산출물들이 언제 어디서 돌아오는지를 관리할 수 없으면 병렬의 의미가 없었습니다. 이 문제들은 Plan이나 TC의 품질이 아니라, **에이전트를 운용하는 구조** 자체에서 풀어야 했습니다. ### Orchestrator-Executor: 토의와 실행의 분리 복수의 작업을 동시에 진행하려면, 각 에이전트에게 직접 지시하는 대신 중앙 조율 주체가 필요했습니다. 그래서 Orchestrator-Executor 패턴을 만들었습니다. **Orchestrator**는 저와의 토의 상대입니다. 요구사항을 분석하고, Plan을 어떻게 구성할지를 함께 논의합니다. 그리고 합의된 작업을 Executor에게 디스패치합니다. Orchestrator에게는 하나의 규칙만 뒀습니다. **읽기는 자유, 쓰기는 Executor를 통해서만.** 코드베이스, Plan, TC 결과, Executor가 남긴 작업 로그 등 모든 것을 읽고 분석할 수 있지만, 파일을 직접 수정하는 것은 금지했습니다. Orchestrator의 본질은 저와 함께 생각하고, Executor들을 조율하는 역할이니까요. Executor가 작업을 끝내면, Orchestrator가 결과를 수집해서 저에게 보고합니다. Plan 완료 체크, TC 결과, Code diff — 제가 검토해야 할 산출물을 정리해서 올려주는 겁니다. **Executor**는 매번 새 세션(fresh session)으로 시작합니다. 이 방식은 GSD(get shit done) 프레임워크에서 차용했습니다. 처음에는 매번 새로운 에이전트를 호출하는 게 맞나 싶었습니다. 이전 맥락을 다 버리는 게 비효율적으로 느껴졌으니까요. 그런데 오히려 이것이 **Plan을 더 정교하게 만들도록 강제하는 환경**이 됐습니다. 세션 기억에 기대면 Plan이 대충 써져도 어떻게든 돌아갑니다. 하지만 매번 맥락이 리셋되는 환경에서는, Plan이 부실하면 Executor가 바로 엉뚱한 방향으로 갑니다. Plan의 품질이 곧 결과의 품질이 되는 구조입니다. 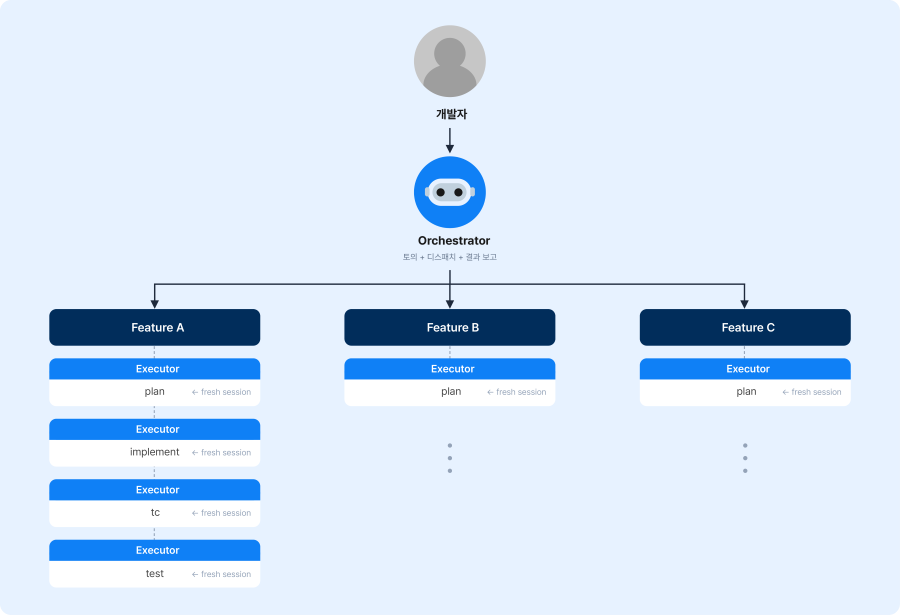 Orchestrator가 Executor에게 보내는 명령은 **전부 스크립트 기반의 정형화된 디스패치**입니다. 사람이 자연어로 지시하는 게 아니라, 스크립트가 Plan 문서, TC 목록, 코딩 컨벤션, 현재 상태 정보를 빠짐없이 조립해서 일관된 형식으로 전달합니다. 같은 단계에는 항상 같은 구조의 프롬프트가 나가기 때문에, 프롬프트의 품질이 사람의 컨디션에 의존하지 않게 됐습니다. 그리고 전부 스크립트로 되어 있다 보니, **어디를 고도화해야 하는지가 명확해졌습니다.** Executor가 같은 실수를 반복하면 디스패치 스크립트에 주의사항을 추가하고, TC가 부족하면 TC 생성 스크립트를 보강하고, Plan 템플릿이 빈약하면 템플릿을 수정합니다. 개선 지점이 흩어져 있지 않고, 스크립트와 템플릿이라는 명시적인 위치에 모여 있었습니다. ### 격리된 실행 환경 여러 기능을 동시에 개발하려면, 각 기능의 코드와 실행 환경이 서로 간섭하지 않아야 합니다. 코드 분리에는 Git Worktree를 사용했습니다. 하나의 Repository에서 여러 작업 디렉터리를 동시에 유지할 수 있는 Git 내장 기능입니다. 피처 티켓마다 독립된 디렉터리를 만들고, 각각에 Executor를 배정하면 코드 충돌 없이 병렬 개발이 가능했습니다. ``` project/ ├── main/ # 메인 브랜치 └── worktrees/ ├── feature-A/ # 기능 A — Executor 작업 영역 ├── feature-B/ # 기능 B — Executor 작업 영역 └── feature-C/ # 기능 C — Executor 작업 영역 ``` 하지만 코드가 분리되어도, 서버 포트, DB, 빌드 캐시를 공유하면 간섭이 발생했습니다. Feature A에서 서버를 띄운 상태로 B에서도 서버를 띄우면 포트가 충돌하고, A의 테스트가 공유 DB의 데이터를 바꾸면 B의 테스트가 실패했습니다. 그래서 기능별로 서버 포트 대역을 나누고, 테스트 DB를 격리하고, 빌드 출력 경로를 분리했습니다. 이 환경 격리가 갖춰져야 **TC를 기능별로 독립적으로** 돌릴 수 있고, TC 결과를 해당 기능의 코드만으로 신뢰할 수 있었습니다.
## 마치며 약 3개월간 이 구조를 실제 업무에 적용하며 하나의 패턴이 선명해졌습니다. AI 에이전트가 코드를 빠르게 작성하는 것 자체는 생산성의 본질이 아니었습니다. 생산성이 올라간 진짜 지점은, **개발자가 과정 대신 산출물을 보게 됐을 때**였습니다. 처음에는 에이전트의 실행 과정을 모니터링하는 대시보드와 패널을 만들었습니다. 어떤 워크트리가 어디까지 진행됐는지, 서버 로그에 오류가 없는지, DB 상태가 올바른지를 실시간으로 관찰하는 도구들이었습니다. 유용했지만, 결국 이것은 **과정을 정교하게 보는 방법**이었습니다. Plan과 TC 자동화가 성숙해지면서, 이 모니터링 도구들을 점점 덜 보게 됐습니다. Plan만 확인하고, TC 결과만 확인하면 충분했으니까요. 결국 병렬 개발의 핵심은 에이전트를 더 똑똑하게 만드는 데 있지 않았습니다. **사람이 검토해야 할 단위를 명확한 산출물로 고정하는 데** 있었습니다. 과정을 보면 과정에 매이고, 산출물을 보면 판단에 집중할 수 있습니다. 이 글이 저와 같은 고민을 하는 동료 개발자 분들께 도움이 되길 바라며 마치겠습니다. 긴 글을 읽어 주셔서 감사합니다. ### 참고 자료 * [Claude Code: Best practices for agentic coding](https://code.claude.com/docs/en/best-practices) * [Claude Code — Git Worktree를 활용한 병렬 개발](https://code.claude.com/docs/en/common-workflows#run-parallel-claude-code-sessions-with-git-worktrees) * [Git Worktree 공식 문서](https://git-scm.com/docs/git-worktree) * [GSD (Get Shit Done) Framework](https://github.com/gsd-build/get-shit-done) [](https://www.nhncloud.com/kr)