요약
Kubernetes에서 서비스를 운영하다 보면 메인 컨테이너 옆에 사이드카(sidecar) 컨테이너를 붙이는 일이 흔합니다. 사이드카에는 로그와 메트릭 수집, 프록시처럼 주 기능은 아니지만 같은 Pod 안에서 함께 실행되어야 하는 기능이 포함됩니다.
저희 팀이 운영하는 관리형 데이터베이스 서비스도 DB 인스턴스를 Pod 단위로 실행하고, 그 Pod에 DB 컨테이너 외에 헬스 체크, 메트릭과 로그 수집 등을 위한 사이드카를 함께 둡니다. 이 사이드카들은 DB와 같은 데이터 볼륨에 접근해야 하므로 같은 Pod 안에 있어야 하지만, 라이프사이클은 DB와 다릅니다. DB는 한 번 실행하면 몇 달씩 그대로 운영하는 반면, 사이드카는 기능 추가와 버그 수정, 보안 패치로 훨씬 자주 바뀝니다.
사이드카가 바뀔 때마다 그 변경을 모든 인스턴스에 반영해야 하는데, DB 서비스는 유지한 채 실행 중인 Pod의 사이드카만 바꿔야 합니다. 사이드카는 모든 DB Pod에 붙으므로 이 작업은 인스턴스 수만큼 반복됩니다.
그 결과 반영 시점이 인스턴스마다 다를 수 있고, 사이드카 종류가 여럿이면 버전 조합도 인스턴스마다 제각각이 됩니다. DB Pod는 오래 실행되니 이 상태가 그대로 굳어지고, 어떤 인스턴스에 어떤 버전이 실행 중인지 알려면 Pod를 하나씩 조회해야 합니다. 사이드카 수가 늘수록 형상 관리와 배포, 모니터링이 모두 어려워집니다.
이 글은 Kubernetes 환경에서 사이드카를 운영하는 독자를 대상으로, 사이드카를 선언적으로 관리할 수단으로 OpenKruise SidecarSet을 도입한 이유, SidecarSet의 기능과 동작 방식, 운영하며 알게 된 점을 다룹니다.
사이드카 관리의 어려움: 형상 관리, 배포, 모니터링
사이드카를 관리하려면 사이드카 이미지를 한곳에 선언하는 형상 관리, 선언을 실행 중인 Pod에 적용하는 배포, 결과를 조회하는 모니터링이 필요합니다. 그런데 Kubernetes만으로는 이 세 가지가 모두 어렵습니다. 예를 들어 로그 수집 사이드카의 이미지를 바꾸면, 그 사이드카가 들어간 모든 DB Pod에 같이 적용되어야 합니다. 하지만 Kubernetes에서 사이드카 이미지는 Pod 스펙이나 Deployment, StatefulSet의 Pod 템플릿마다 따로 지정되어 있어서 한 번에 바꿀 방법이 없습니다.
Pod 템플릿을 고치면 Kubernetes가 Pod를 다시 만들면서 새 이미지를 적용합니다. 하지만 이 과정에서 DB 컨테이너도 함께 재시작되므로 사이드카를 바꿀 때마다 이 방법을 쓸 수는 없습니다. DB는 그대로 둔 채 사이드카만 바꾸려면 실행 중인 Pod의 이미지를 직접 수정(in-place 갱신)해야 합니다. 이때 kubelet은 이미지가 바뀐 컨테이너만 다시 시작하므로 DB 컨테이너는 영향을 받지 않습니다. 다만 이렇게 수정할 수 있는 컨테이너 스펙은 이미지뿐이고, 수정도 Pod마다 따로 해야 합니다. 사이드카 이미지가 바뀔 때마다 대상 Pod를 찾아 하나씩 고치는 일은 Kubernetes가 해 주지 않습니다.
조회도 같은 한계가 있습니다. Deployment, StatefulSet의 status에 updatedReplicas가 있지만 템플릿 기준이므로, Pod에서 직접 바꾼 이미지는 집계되지 않습니다. 반영 여부를 확인하려면 Pod마다 status에 기록된 이미지를 선언과 하나씩 비교해야 합니다. Kubernetes는 워크로드 단위의 재생성과 Pod 하나의 이미지 교체까지만 제공합니다. 여러 워크로드의 사이드카를 한곳에 선언하고, DB를 유지한 채 실행 중인 Pod에 반영하며, 그 결과를 조회하려면 별도의 수단이 필요합니다.
직접 만들 것인가, 가져다 쓸 것인가
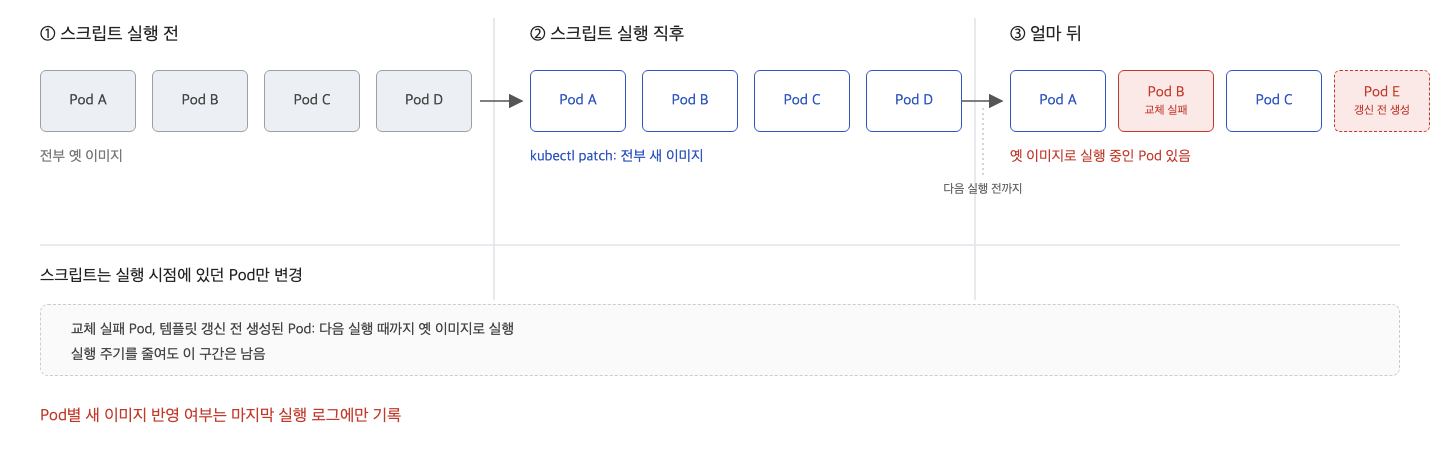
가장 단순하게는 대상 Pod를 순회하며 사이드카 이미지를 패치하는 스크립트를 만들 수 있습니다. 그런데 스크립트는 실행한 순간의 Pod 목록에 패치를 보내고 끝나므로, 패치가 실제로 반영됐는지 확인하고 실패한 Pod에 패치를 다시 보내려면 또 다른 스크립트가 필요합니다. 실행 뒤에 생긴 변화도 마찬가지입니다. 사람이 직접 이미지를 되돌린 Pod나 옛 템플릿으로 새로 만들어진 Pod는 다음 스크립트 실행 전까지 이전 버전으로 유지됩니다.
그림 1. 스크립트 실행 사이의 선언과 실제의 어긋남
갱신이 제대로 끝났는지 확인하는 것도 간단하지 않습니다. kubelet이 이미지를 내려받아 컨테이너를 다시 시작하는 과정에서 내려받기가 실패할 수 있고, status의 이미지 태그만 봐서는 교체가 끝났는지 정확히 알 수 없습니다. 또 어디까지 갱신되었는지를 따로 관리하지 않으면, 갱신을 실행할 때마다 전체 Pod를 확인해야 합니다.
결국 필요한 것은 한 번 실행하고 끝나는 스크립트가 아니라, 의도한 상태(desired state)를 기준으로 실행 중인 Pod를 계속 비교해 맞추는 조정 루프(reconcile loop), 즉 컨트롤러입니다. 이 루프를 저희가 이미 운영 중인 DB 오퍼레이터(DB 인스턴스의 생성과 운영을 자동화하는 컨트롤러)에 넣는 방법도 있습니다. 하지만 이 경우에도 조정 루프를 오퍼레이터 안에 직접 구현해야 합니다. 이미지를 패치하는 것 자체는 Kubernetes가 제공하므로 간단하지만, 이를 안정적으로 운영하려면 다음 네 가지를 갖춰야 합니다.
- 완료 판정: kubelet이 컨테이너를 실제로 교체했음을 확인
- 동시성과 범위 제어: 동시에 교체할 개수와 적용 범위를 정하고, 일시 정지와 재개를 지원
- 진행 집계: 전체 대상 수와 교체가 끝난 수, 정상 상태인 수를 집계
- 컨트롤러 운영: 컨트롤러 자체의 배포와 가용성, 장애가 났을 때 클러스터에 미치는 영향 관리
이 문제가 저희 팀에만 국한되지는 않을 것이라고 판단했습니다. Kubernetes에서 사이드카를 두고 서비스를 운영하는 팀이라면 어디서든 마주칠 수 있는 문제이기 때문입니다. 그래서 직접 만들기 전에 기존 해결책을 찾아봤습니다. Istio처럼 Pod 생성 시점에 mutating 웹훅으로 사이드카를 주입하는 구현은 여럿 있지만, 실행 중인 Pod의 사이드카를 선언에 맞춰 갱신하지는 않았습니다.
반면 OpenKruise의 SidecarSet은 이 요건까지 갖춘 것으로 확인했습니다. OpenKruise는 Kubernetes의 워크로드 기능을 확장하는 CNCF(Cloud Native Computing Foundation) 인큐베이팅 프로젝트이고, SidecarSet은 사이드카 컨테이너의 라이프사이클을 메인 컨테이너와 분리해 관리하도록 OpenKruise가 제공하는 CR(Custom Resource)입니다.
SidecarSet에서는 새 Pod에 웹훅이 항상 최신 정의를 주입하고, 선언을 바꾸면 컨트롤러가 실행 중인 Pod를 맞추므로, 스크립트 실행 사이에 새 Pod가 이전 버전으로 남는 구간이 생기지 않습니다. 다만 사람이 직접 바꾼 Pod는 이 방식으로도 감지되지 않아 운영 규칙으로 막았습니다. 또 컨트롤러는 자신이 주입한 컨테이너를 이름으로 찾아 그 이미지만 바꾸므로, 같은 Pod의 DB 컨테이너 이미지는 바꾸지 않습니다. 외부 컴포넌트가 늘어나는 운영 부담을 감수하면서도 SidecarSet을 도입한 이유는 SidecarSet이 컨트롤러 운영을 제외한 나머지 기능인 완료 판정, 동시성과 범위 제어, 진행 집계를 이미 갖추고 있었기 때문입니다.
SidecarSet의 기능
SidecarSet은 형상 관리, 배포, 모니터링을 각각 CR의 선언, updateStrategy, status로 제공합니다. 앞에서 정리한 네 가지 요건 중 동시성과 범위 제어는 updateStrategy가, 진행 집계는 status가 맡습니다. 완료 판정은 SidecarSet의 동작 방식에서, 컨트롤러 운영의 부담은 운영에서 주의할 점에서 다룹니다. 이 글의 동작 설명은 저희가 운영 중인 OpenKruise v1.8.3 기준입니다.
형상 관리: 사이드카 정의를 CR 하나에
CR에는 사이드카 컨테이너의 정의 전체가 들어갑니다. 이미지는 물론 실행 사용자와 capability를 정하는 securityContext, 마운트할 볼륨, 기동 인자와 환경 변수, 포트, preStop 훅(hook)까지 담을 수 있습니다. 주입 대상을 정하는 레이블 조건도 같은 CR에 있어서, 사이드카에 관한 선언이 한곳에 모입니다.
다음은 주입 대상, 주입할 사이드카, 갱신 방식을 SidecarSet 하나에 함께 선언한 예시입니다. partition과 maxUnavailable은 배포 절에서 설명합니다.
apiVersion: apps.kruise.io/v1alpha1
kind: SidecarSet
metadata:
  name: mysql-exporter
spec:
  namespaceSelector:        # 주입할 네임스페이스
    matchLabels:
      example.com/managed: "true"
  selector:                 # 주입할 Pod
    matchLabels:
      example.com/mysql: "true"
  containers:
  - name: exporter
    image: prom/mysqld-exporter@sha256:<digest>
    volumeMounts:
    - name: mysql            # DB 컨테이너와 같은 데이터 볼륨
      mountPath: /var/lib/mysql
  updateStrategy:
    type: RollingUpdate
    partition: 100%
    maxUnavailable: 1
다만 선언 내용이 모두 바로 반영되지는 않습니다. 선언을 바꿨을 때 즉시 적용되는 항목은 이미지 하나입니다. 실행 중인 Pod에서 고칠 수 있는 컨테이너 스펙이 이미지뿐이기 때문입니다. 이미지를 제외한 나머지 선언 내용은 그 Pod가 다시 만들어질 때 반영됩니다.
| 선언 내용 | 반영 시점 |
|---|---|
| 이미지 | 즉시 |
securityContext, 볼륨, 환경 변수, 기동 인자, 포트, preStop | Pod가 다시 만들어질 때 |
| 주입 대상 레이블 조건 | Pod가 다시 만들어질 때 |
이 차이 때문에 생기는 재시작은 운영에서 주의할 점에서 다룹니다.
배포: partition과 maxUnavailable
updateStrategy의 두 필드가 적용 범위와 속도를 정합니다.
| 필드 | 설명 | 기본값 |
|---|---|---|
partition | 범위: 이전 버전으로 남겨 둘 Pod 수나 비율 | 0 |
maxUnavailable | 속도: 동시에 교체 중일 수 있는 최대 Pod 수나 비율. 교체 후 Ready가 되지 않은 Pod도 포함 | 1 |
주입된 Pod가 12개이고 partition이 50%, maxUnavailable이 1이면 6개를 새 버전으로 교체하며, 한 번에 한 개씩 진행합니다. 교체한 Pod가 Ready가 되면 다음 Pod로 넘어갑니다. 즉, 일정 수만큼 묶어 진행하는 것이 아니라, Pod 하나가 Ready가 될 때마다 다음 Pod의 교체를 시작합니다. updateStrategy.paused를 true로 두면 롤아웃이 그 자리에서 멈춥니다.
교체 전부터 Ready가 아니던 Pod는 예외입니다. 컨트롤러는 partition으로 허용된 범위 안에서 이런 Pod를 가장 먼저 교체하고, maxUnavailable에도 세지 않으므로 여러 개라면 한꺼번에 교체합니다. 저희 서비스는 healthchecker 사이드카가 DB 컨테이너의 readiness를 판정하므로, DB가 정상이 아닌 인스턴스의 사이드카가 먼저 바뀝니다.
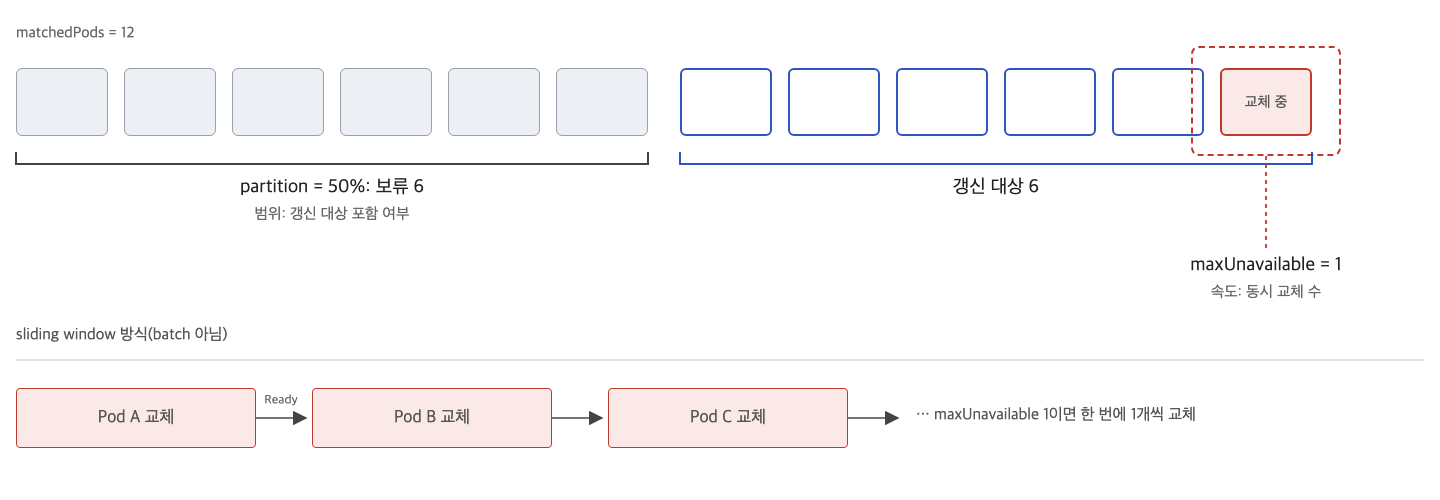
그림 2. partition(범위)과 maxUnavailable(속도)
partition은 개수나 비율로만 범위를 정합니다. 어떤 Pod에 먼저 적용할지를 레이블로 고르는 updateStrategy.selector도 있지만, partition과 함께 지정하면 validating 웹훅에서 이를 거부합니다.
admission webhook "vsidecarset.kb.io" denied the request:
updateStrategy: Invalid value: ...: Partition and Selector cannot be used together
저희는 partition만 쓰기로 했습니다. 롤아웃을 단계로 나눈 것은 문제가 생겼을 때 영향 범위를 줄이기 위해서였는데, 그러려면 몇 개까지 적용할지만 정하면 됐고 어떤 Pod에 먼저 적용할지까지 고를 필요는 없었습니다. 그래서 전체를 대상으로 두고 partition 값을 단계적으로 내려 적용 범위를 넓혔습니다.
모니터링: status의 네 가지 지표
status는 진행 상황을 숫자 네 개로 보여 줍니다.
| 필드 | 집계 대상 |
|---|---|
matchedPods | 주입된 Pod 수. 진척률의 분모 |
updatedPods | 최신 리비전이 Pod 스펙에 반영된 Pod 수. kubelet의 교체가 끝나지 않은 Pod도 포함. 진척률의 분자 |
readyPods | 버전과 관계없이 Ready인 Pod 수 |
updatedReadyPods | 최신 리비전으로 교체가 끝났고 Ready인 Pod 수 |
각 필드는 다음과 같이 포함 관계에 있습니다.
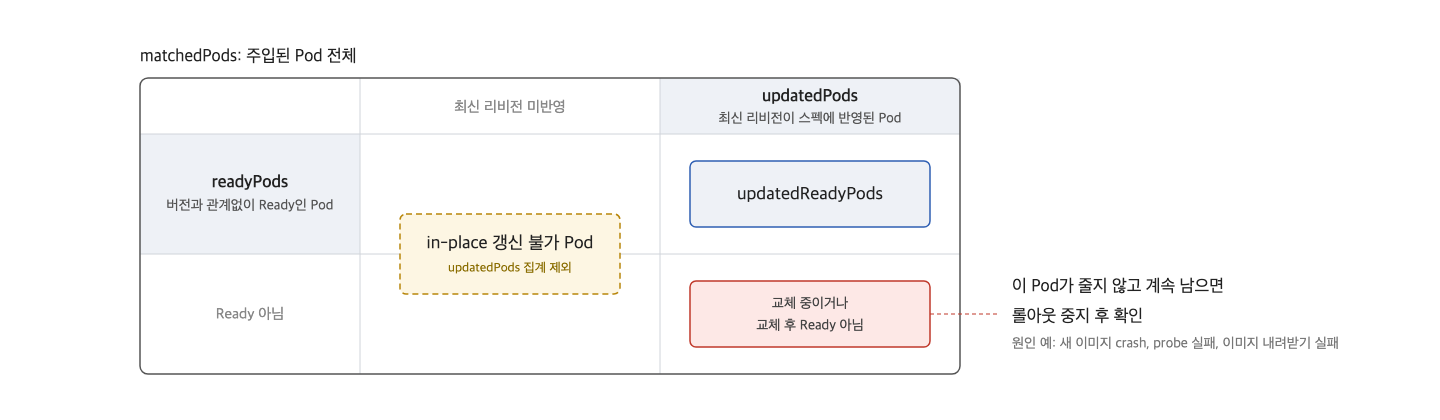
그림 3. status 네 필드의 포함 관계와 in-place 갱신이 불가능한 Pod
updatedPods와 readyPods는 matchedPods 안에 들어가고, updatedReadyPods는 그 둘에 모두 속하는 Pod입니다. updatedPods는 최신 리비전이 스펙에 반영된 Pod 수를, updatedReadyPods는 최신 리비전으로 교체가 끝났고 정상인 Pod 수를 셉니다.
새 이미지의 컨테이너가 비정상 종료되거나 readiness probe를 통과하지 못하면 그 Pod는 updatedPods에는 집계되지만 updatedReadyPods에는 집계되지 않습니다. 이때 컨트롤러는 교체 중이거나 교체 후 Ready가 되지 않은 Pod를 maxUnavailable에 포함해 세므로, 한도를 채우면 더 진행하지 않습니다. 두 숫자의 차이가 줄지 않으면 운영자는 선언의 이미지를 되돌립니다.
다만 컨테이너만 바꾸는 in-place 갱신이 불가능한 Pod는 updatedPods에 집계되지 않으며, 이런 Pod의 수를 따로 나타내는 숫자도 없습니다. 이 경우는 운영에서 주의할 점에서 다룹니다.
SidecarSet의 동작 방식
SidecarSet은 Kubernetes의 두 가지 확장 지점인 admission 웹훅과 컨트롤러로 구현되어 있습니다. 구체적으로는 Pod 생성 시 스펙을 변형하는 mutating 웹훅과 SidecarSet 정의를 검증하는 validating 웹훅, 그리고 CR을 보고 실제 상태를 맞추는 kruise 컨트롤러입니다. SidecarSet의 갱신에 노드 쪽 별도 컴포넌트는 쓰이지 않습니다. 실제로 컨테이너를 교체하는 작업은 각 노드의 kubelet에서 수행하며, 이는 Kubernetes의 표준 동작입니다.
주입은 생성 시점에만
주입 대상은 CR의 Pod 레이블 셀렉터로 정하고, 네임스페이스 조건으로 범위를 더 좁힐 수 있습니다. 저희는 둘을 함께 씁니다. Pod 생성 요청이 들어오면 웹훅이 호출되어 CR에 적힌 사이드카 컨테이너를 스펙에 넣고, 어떤 SidecarSet이 무엇을 넣었는지 Pod의 어노테이션에 기록합니다. 이후 컨트롤러는 이 기록이 있는 Pod만 관리합니다.
Pod가 생성된 뒤에는 주입이 이뤄지지 않습니다. Kubernetes는 실행 중인 Pod에 일반 컨테이너 추가를 허용하지 않으므로, CR에 사이드카를 새로 추가해도 이미 실행 중인 Pod에는 들어가지 않습니다.
이미지 교체는 kubelet이 컨테이너 단위로 처리
컨테이너 이미지 갱신의 바탕에는 SidecarSet이 아니라 Kubernetes의 표준 동작이 있습니다. 실행 중인 Pod의 이미지 교체가 실제로 어떻게 이뤄지는지, 별도 클러스터에서 kubectl patch만으로 확인했습니다. 컨테이너 네 개가 있는 Pod에서 그중 두 개의 이미지만 바꿉니다.
apiVersion: v1
kind: Pod
metadata:
  name: multi-sidecar
spec:
  containers:
  - { name: main,      image: busybox:1.36, command: [sh, -c, sleep 100000] }
  - { name: sidecar-a, image: busybox:1.36, command: [sh, -c, sleep 100000] }
  - { name: sidecar-b, image: busybox:1.36, command: [sh, -c, sleep 100000] }
  - { name: sidecar-c, image: busybox:1.36, command: [sh, -c, sleep 100000] }
kubectl patch pod multi-sidecar --type=json -p='[
  {"op":"replace","path":"/spec/containers/1/image","value":"busybox:1.37"},
  {"op":"replace","path":"/spec/containers/3/image","value":"alpine:3.20"}
]'
결과는 다음과 같습니다.
| 컨테이너 | 이미지 | restartCount | containerID |
|---|---|---|---|
main | busybox:1.36(그대로) | 0 유지 | 동일 |
sidecar-a | busybox:1.36 → 1.37 | 0 → 1 | 교체 |
sidecar-b | busybox:1.36(그대로) | 0 유지 | 동일 |
sidecar-c | busybox:1.36 → alpine:3.20 | 0 → 1 | 교체 |
이미지를 바꾼 두 컨테이너만 재시작되며, 나머지는 restartCount가 0에 머물고 containerID도 그대로입니다. Pod는 다시 만들어지지 않습니다. uid, startTime, Pod IP가 유지되고, pause 컨테이너와 네트워크 네임스페이스로 이루어진 Pod 샌드박스와 볼륨도 그대로 남습니다. 메인 컨테이너 안에서 ps를 실행해 보면 PID 1이 컨테이너가 처음 시작된 시점부터 계속 실행 중입니다. 한 요청에서 두 컨테이너를 동시에 바꾸고 그중 하나는 전혀 다른 이미지(busybox → alpine)로 바꿨는데도 이런 결과가 나왔습니다.
이미지를 바꾼 컨테이너만 재시작되는 이유는 kubelet의 동작 방식에 있습니다. API 서버에서 바뀐 스펙은 해당 노드의 kubelet에 전달됩니다. kubelet은 실행 중인 각 컨테이너에 그 컨테이너 스펙의 해시를 기록해 두고, 새로 받은 스펙의 해시가 기록된 값과 다르면 그 컨테이너만 종료한 뒤 다시 만듭니다. 이미지가 바뀌면 해시가 바뀌고, 이 과정은 이벤트(Event)에 그대로 남습니다.
Killing   Container sidecar-a definition changed, will be restarted
Killing   Container sidecar-c definition changed, will be restarted
DB Pod에서도 마찬가지로, 사이드카 이미지만 바꾸면 스펙이 그대로인 DB 컨테이너는 재시작되지 않습니다. feature gate나 특정 Kubernetes 버전이 있어야 동작하는 것도 아닙니다.
컨트롤러의 역할: 대상 선정과 완료 판정
컨트롤러가 하는 일은 크게 두 가지입니다. 바꿀 Pod를 골라 이미지를 바꿔 쓰는 일과, kubelet이 교체를 끝냈는지 확인하는 일입니다.
바꿀 Pod는 해시로 고릅니다. 컨트롤러는 Pod 스펙의 이미지 값을 직접 비교하지 않고, CR의 내용으로 해시를 만들어, 주입하거나 갱신할 때 Pod에 기록해 둔 해시와 비교합니다. 두 값이 다르면 그 Pod는 아직 갱신되지 않은 것으로 판정합니다. 해시는 이미지까지 포함한 것과 이미지를 제외한 것, 두 종류입니다. 이미지만 달라졌다면 Pod를 그대로 두고 컨테이너만 바꾸는 in-place 갱신이 가능하지만 그 밖의 필드가 달라졌다면 불가능합니다. 이를 구분하려고 해시를 둘로 나눈 것입니다.
컨트롤러는 대상으로 선택된 Pod의 스펙에서 해당 컨테이너의 image를 CR의 값으로 바꿔 씁니다. 앞에서 kubectl로 한 것과 같은 조작이고, 그 조작에 따른 컨테이너 교체는 kubelet의 몫입니다.
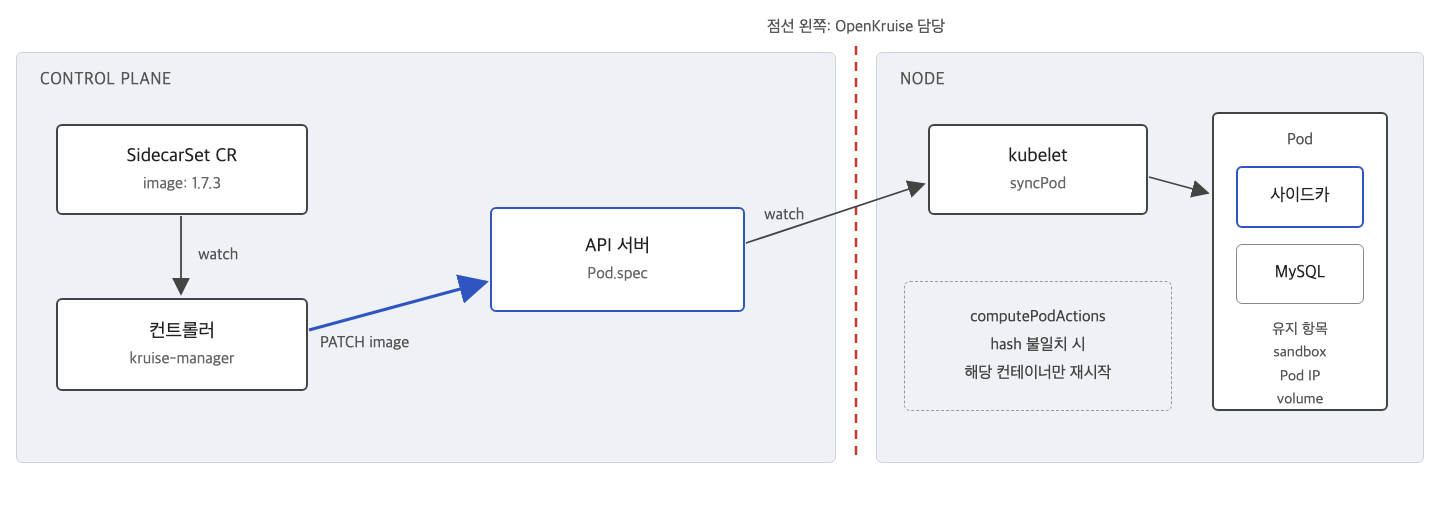
그림 4. 컨트롤러와 kubelet의 역할 경계
컨트롤러가 API 서버에 이미지를 바꿔 쓰면, 이후 컨테이너 교체는 그림 4의 점선 오른쪽, 즉 kubelet의 표준 동기화 루프에서 이뤄집니다. 앞에서 본 kubelet의 해시 비교가 그 안에 있습니다. 컨트롤러는 그 뒤에 kubelet이 실제로 컨테이너를 바꿨는지 판정합니다.
교체가 끝났는지를 status.containerStatuses[].image의 태그로 판정하면 두 가지 문제가 있습니다.
- 교체됐는데 안 됐다고 판정하는 경우: 이미지 내용이 같으면 태그를 새로 붙여도 다이제스트(이미지 내용으로 계산한 고윳값)가 같으므로 kubelet은 그 노드가 먼저 알고 있던 태그를
status에 표시합니다. - 교체되지 않았는데 됐다고 판정하는 경우: 같은 태그로 내용만 바꿔 올리면 스펙이 그대로여서 컨테이너는 교체되지 않지만
status의 태그는 선언과 같습니다.
컨트롤러는 태그만으로 판정하지 않고 imageID를 함께 봅니다. imageID는 실행 중인 컨테이너 이미지의 다이제스트입니다. 컨트롤러는 이미지를 바꾸기 직전의 imageID를 Pod 어노테이션에 적어 두고, 교체 뒤 이 값이 달라졌으면 완료로 판정합니다. imageID가 그대로여도 status의 이미지가 선언과 같으면 완료로 판정합니다. 이 두 경우가 아닐 때만 미완료로 남깁니다. 새 이미지의 다이제스트를 레지스트리에서 조회하지 않고, 바뀌었는지만 확인하는 방식입니다.
다만 이 방식으로도 태그 판정의 두 문제가 모두 사라지지는 않습니다. 첫째, 새 태그만 붙이고 내용이 같으면 imageID가 바뀌지 않고 status의 이미지도 이전 태그로 표시되어 교체가 끝났는데도 미완료로 남습니다. 둘째, 같은 태그로 내용만 바꾸면 선언이 바뀌지 않아 교체가 시작되지 않습니다. 사이드카 이미지를 모두 태그 대신 다이제스트로 선언하면 컨트롤러가 그 다이제스트를 imageID와 바로 비교하므로 두 문제 모두 생기지 않습니다.
정리하면, 선언은 CR 한곳에 모이지만 그것을 Pod에 옮기는 주체는 나뉘어 있습니다. 새 Pod는 웹훅이 주입하고, 실행 중인 Pod는 컨트롤러가 판정해 이미지를 바꿔 쓰며, 실제 교체는 kubelet이 합니다. 선언의 범위와 즉시 반영되는 범위가 다른 것도 이 구조에서 기인합니다.
운영에서 주의할 점: 롤아웃, 재시작, 웹훅
SidecarSet을 운영하면서 주의가 필요했던 점은 세 가지입니다. 기본값대로 두었을 때의 롤아웃 동작, 이미지 외의 변경과 도입 시점에 필요한 재시작, kruise 컨트롤러와 웹훅이 추가되면서 생긴 장애 지점입니다.
롤아웃은 선언하는 순간 시작
partition은 기본값이 0입니다. 아무것도 지정하지 않으면 컨트롤러는 새 이미지가 선언되는 즉시 주입된 Pod 전체의 갱신을 시작합니다. 새 버전을 선언만 해 두고 적용은 나중에 하려 했다면, 의도한 시점보다 먼저 롤아웃이 시작됩니다.
maxUnavailable이 기본값 1이면 한 번에 한 개씩 교체되므로, 대상이 많을수록 롤아웃이 길어집니다. updateStrategy.paused로 진행을 멈출 수는 있지만, 이미 교체된 Pod를 되돌리려면 이미지를 이전 버전으로 선언하고 같은 절차로 다시 진행해야 하므로 되돌리는 데에도 그만큼 시간이 듭니다.
그래서 새 버전의 선언과 적용을 분리했습니다. 매니페스트에는 partition: 100%로 고정합니다.
updateStrategy:
  type: RollingUpdate
  partition: 100%     # 기존 Pod 자동 갱신 차단
이렇게 설정하면 배포 파이프라인이 SidecarSet을 apply해도 기존 Pod는 그대로이고, 새로 만들어지는 Pod에만 새 이미지가 주입됩니다. partition 값을 내려야 비로소 기존 Pod의 교체가 시작됩니다. 전체 절차는 다음과 같습니다.
# 1단계: 선언(배포 파이프라인)
for each sidecarset manifest:
    image <- 새 버전
    partition <- 100%              # 매니페스트에 고정된 값

repeat until ok or timeout:        # 주입 웹훅이 응답하는지 먼저 확인
    server-side dry-run apply
if timeout: abort                  # 타임아웃이면 배포 중단
apply

# 2단계: 적용(별도 절차로만 시작)
while partition > 0:
    partition <- 더 낮은 값         # 단계는 사람이 정한다
    관측: status의 네 숫자
    if 이상 징후: stop             # 다음 단계로 내리지 않으면 롤아웃이 멈춘다
1단계의 dry-run은 실제로 apply하기 전에 kruise의 웹훅 서버가 응답하는지 확인하는 절차입니다. SidecarSet apply도 같은 서버의 validating 웹훅을 거치므로, dry-run이 통과하면 주입 웹훅도 응답하는 상태로 볼 수 있습니다. 응답할 때까지 짧은 간격으로 재시도하고, 제한 시간 안에 응답이 없으면 배포를 중단합니다.
2단계는 배포 파이프라인이 아니라 별도 절차로만 시작합니다. 한 번에 적용할 범위는 사람이 정하고, 문제가 생기면 partition 값을 더 내리지 않는 것으로 롤아웃을 멈춥니다. 원상 복구가 필요하다면 SidecarSet의 이미지를 이전 버전으로 되돌리고, 이후는 적용과 같은 절차로 진행합니다.
절차 밖의 조작도 통제해야 합니다. 앞에서 본 대로 컨트롤러는 이미지 값이 아니라 해시를 비교합니다. 사람이 kubectl로 이미지를 직접 바꿔 놓으면, 컨트롤러는 그 Pod를 이미 갱신된 것으로 판단하거나 다음 롤아웃 때 선언에 적힌 이미지로 되돌립니다. 어느 쪽이든 오류나 로그는 남지 않습니다. 그래서 사이드카 이미지는 SidecarSet을 통해서만 바꾼다는 운영 규칙을 두었습니다.
Pod 재시작이 필요한 경우
SidecarSet을 써도 Pod를 다시 만들어야 하는 경우가 있습니다. 이미지 외의 스펙을 바꿀 때와 SidecarSet을 처음 도입할 때입니다.
이미지 외의 변경
실행 중인 Pod에서 이미지만 바꿀 수 있다는 Kubernetes의 제약은 SidecarSet에도 그대로 적용됩니다. 선언에서 이미지 외의 필드를 바꾸면, 그 변경은 각 Pod가 다시 만들어질 때 반영됩니다.
이렇게 in-place 갱신이 불가능한 Pod는 matchedPods에는 포함되지만 updatedPods에는 집계되지 않습니다. 앞에서 본 두 해시 중 이미지를 제외한 쪽이 다르면, 컨트롤러는 오류 없이 그 Pod를 건너뜁니다. 그림 3에서 updatedPods 밖에 따로 표시한 것이 이 Pod입니다.
이 Pod를 직접 확인할 수 있는 단서는 두 가지뿐입니다.
- Pod의 condition
SidecarSetUpgradable이 false가 되고, 사유가UpdateImmutableField로 표시됩니다. - SidecarSet의 이벤트에 해당 Pod 수가 기록됩니다.
대시보드에서는 updatedPods가 어느 지점에서 더 늘어나지 않는 것으로만 확인할 수 있습니다. 그래서 이 상태를 감지하는 것보다, 사이드카 스펙을 설계할 때부터 이미지 외의 필드가 바뀌지 않도록 하는 편이 낫습니다.
도입 시점의 재시작
재시작은 도입 시점에도 한 번 필요합니다. SidecarSet은 주입할 때 남긴 어노테이션으로 관리할 Pod를 식별하므로, 도입 전에 만들어진 Pod는 SidecarSet을 선언해도 컨트롤러가 관리하지 않습니다. 각 Pod가 한 번 다시 만들어져야 주입 기록이 남고, 그 뒤부터 컨트롤러가 관리합니다. 그래서 기존 Pod를 언제 어떻게 다시 만들지 별도 계획이 필요합니다.
실제로 재시작한 사례
운영 중에 실제로 재시작이 필요했던 경우는 두 가지였습니다. 첫째는 보안 관련 시스템을 추가로 도입하면서 Pod 스펙을 변경해야 했던 경우입니다. 실행 중인 Pod에는 반영할 수 없는 변경이라 사전 공지 후 전체 인스턴스를 재시작했습니다. 프라이머리-레플리카 구성에서는 레플리카를 먼저 재시작하고 페일오버한 뒤 남은 쪽을 재시작하는 롤링 방식으로 진행하면, 서비스에 미치는 영향을 페일오버에 걸리는 시간 정도로 줄일 수 있습니다.
둘째는 새 기능(예: 감사 로그)을 추가하면서 사이드카 스펙을 변경해야 했던 경우입니다. 이때는 전체를 한 번에 재시작하지 않고, 기능을 처음 켤 때 해당 인스턴스를 한 번 재시작해야 한다는 점을 고객에게 기능 사용 조건으로 안내했습니다.
두 경우 모두 이미지 외의 변경에는 Pod 재시작이 필요하다는 전제로 영향도를 미리 검토했고, 변경의 성격에 따라 재시작 시점을 골랐습니다.
관리 계층이 늘면 장애 지점도 증가
SidecarSet을 도입하면 클러스터에 kruise의 컨트롤러와 웹훅이 추가됩니다. 이 중 웹훅에 장애가 나면 SidecarSet과 무관한 Pod 요청까지 실패합니다.
OpenKruise는 Pod에 대한 여러 요청에 failurePolicy: Fail인 웹훅을 등록합니다. Pod 생성에는 사이드카를 주입하는 mutating 웹훅이, Pod 수정과 삭제, eviction(노드에서 Pod를 내보내는 요청)에는 validating 웹훅이 호출됩니다. 어떤 Pod에 어떤 사이드카를 넣을지는 웹훅에서 판정하므로, API 서버는 설치 설정에서 제외한 네임스페이스 밖의 Pod 요청을 모두 웹훅으로 보냅니다. 웹훅이 응답하지 못하면 이 요청들은 거부됩니다.
별도 클러스터에서 응답할 수 있는 웹훅 Pod가 없는 상태를 만들어 확인해 보면, Pod 생성 요청은 타임아웃까지 기다린 뒤 failed calling webhook으로 거부되고 Pod 오브젝트 자체가 만들어지지 않습니다. 저희 서비스에서는 인스턴스 생성과 레플리카 추가가 여기에 해당합니다. 수정과 삭제, eviction의 웹훅도 같은 failurePolicy이므로, 인스턴스 삭제와 노드 drain(노드의 Pod를 모두 내보내는 작업), 오퍼레이터가 Pod의 레이블이나 어노테이션을 고치는 요청도 함께 실패합니다.
failurePolicy: Fail은 의도된 설정입니다. 주입 웹훅의 failurePolicy를 Ignore로 두면 웹훅이 응답하지 못해도 Pod 생성은 성공하지만, 사이드카가 빠진 Pod가 오류 없이 만들어집니다. 실행 중인 Pod에는 컨테이너를 추가할 수 없으므로 그 Pod는 재생성하기 전까지 사이드카 없이 남습니다.
웹훅에 장애가 나도 영향을 받는 것은 API 서버로 들어오는 Pod 요청과 SidecarSet 변경 요청뿐입니다. 이미 실행 중인 Pod의 동작에는 웹훅이 호출되는 요청이 필요하지 않으므로 DB와 사이드카는 그대로 동작하고, 컨테이너가 재시작되어도 kubelet이 처리합니다.
웹훅을 복구하는 일도 막히지 않습니다. 저희 클러스터는 kruise가 설치된 네임스페이스를 웹훅 대상에서 제외해 두었으므로, 웹훅 Pod 자체는 다시 만들 수 있습니다. 웹훅이 복구되면 그동안 거부된 요청은 오퍼레이터와 컨트롤러가 재시도하면서 다시 처리되므로, 따로 정리할 필요가 없습니다.
SidecarSet 없이 직접 구현하더라도 관리 계층이 늘어나는 것은 피할 수 없습니다. Pod를 만드는 코드에 주입 로직을 넣으면 웹훅 없이도 주입할 수 있지만 그 코드가 같은 장애 지점이 됩니다. 갱신을 맡는 조정 루프를 만들면 그 루프의 배포와 가용성을 직접 관리해야 합니다. 관리 계층을 두면 그 계층의 가용성을 관리하는 비용이 생기는데, 이는 도구를 쓰든 직접 만들든 마찬가지입니다. 그러므로 추가된 컴포넌트의 실패 방식을 미리 확인하고 대비해야 합니다.
저희는 웹훅을 함께 처리하는 kruise 컨트롤러를 여러 레플리카로 서로 다른 노드에 두었습니다. 배포 절차 1단계에서는 dry-run으로 웹훅 응답을 먼저 확인하고, 위의 영향 범위는 장애 대응 절차에 반영해 두었습니다. 이렇게 하면 웹훅에 장애가 나도 영향을 미리 알고 있는 범위 안에서 대응할 수 있습니다.
마치며
사이드카에 관한 선언이 없었던 것은 아닙니다. 어떤 사이드카를 어떤 이미지로 실행할지는 Pod 스펙마다 지정되어 있었습니다. 없던 것은 여러 Pod에 공통으로 적용되는 의도한 상태와, 이 상태가 바뀌면 실행 중인 Pod를 찾아 그에 맞게 갱신하는 컨트롤러였습니다. 이미지 교체 자체는 Kubernetes가 원래 제공하는 기능이고, SidecarSet은 그 기능을 선언에 맞춰 반복해서 실행하는 컨트롤러를 제공합니다. 이로써 사이드카의 형상은 CR 하나로 관리하고, 배포는 partition과 maxUnavailable로 조절하며, 반영 현황은 status의 네 숫자로 확인합니다. 사이드카 이미지만 바꿀 때는 DB를 재시작하지 않습니다.
SidecarSet을 도입하고 운영하면서 배운 점은 다음과 같습니다.
- 선언해 두는 것과 선언대로 관리되는 것은 다릅니다. 선언을 계속 읽고 그에 맞춰 갱신하는 컨트롤러가 없으면 그 선언은 Pod 생성 시점의 초깃값일 뿐입니다.
- 플랫폼이 원래 제공하는 기능을 먼저 확인해야 합니다. 이미지 교체는 Kubernetes가, 선언에 맞춘 반복 적용은 SidecarSet이 합니다. 이를 구분해야 무엇을 가져다 쓰고 무엇을 직접 만들지 정할 수 있습니다.
- 새 버전의 선언과 적용은 분리해야 합니다.
partition기본값 0은 선언 즉시 롤아웃을 시작합니다. 선언과 적용을 분리해 두어야 적용의 속도와 범위를 사람이 정할 수 있습니다. - 이미지 외의 변경과 도입 시점에는 Pod 재시작이 필요합니다. in-place 갱신이 불가능한 Pod는
status에서 따로 드러나지 않아 알아채기 어려우므로, 사이드카 스펙을 설계할 때부터 이미지 외의 필드가 바뀌지 않도록 하는 편이 낫습니다. 도입 전에 만들어진 Pod도 한 번 다시 만들어져야 관리 대상이 되므로, 기존 Pod를 언제 어떻게 다시 만들지 도입 전에 계획해야 합니다. - 외부 도구는 도입하기 전에, 실패했을 때의 영향부터 확인해야 합니다. 요구하는 기능이 있는지는 문서로 확인할 수 있지만, kruise 웹훅의 장애가 SidecarSet과 무관한 Pod 요청까지 막는다는 영향은 admission 웹훅의 동작을 이해해야 알 수 있습니다.
참고 자료
- OpenKruise: SidecarSet
- Kubernetes: Pod update and replacement
- Kubernetes: Sidecar Containers
- Kubernetes: Dynamic Admission Control
- Istio: Installing the Sidecar
- CNCF: OpenKruise becomes a CNCF incubating project
저자: 이은성 [ Linux Engineering ]
소개: 네이버클라우드에서 관리형 데이터베이스 서비스를 개발하고 있습니다.