요약
시작하며: 2018년과 2026년 사이의 간격과 격변기의 고민
2018년에 저는 '백엔드 개발자를 꿈꾸는 학생개발자에게'라는 글을 이곳 D2 블로그에 공유했습니다. 당시 학생 개발자들과의 미트업 행사에서 나왔던 질문과 답변을 정리한 글이었습니다. 그 후 8년의 시간이 흘렀기에 그 글만 노출된다면 학생들에게 현시점에 적절한 정보를 주지 못할까 봐 걱정되었습니다. 그래서 2025년 말 설문으로 질문을 받아 후속편을 작성했습니다.
그동안 저도 경험과 지식을 더 쌓았습니다. 하지만 지금 학생 개발자들이 한 질문에는 답하기가 더 어려워졌습니다. 개발자의 역할과 같은 큰 주제를 묻는 질문이 많았는데, 지금은 AI로 인한 변화가 큰 시기이기 때문입니다. 스스로도 확신이 없는 시기에 이런 글을 쓰는 것이 적절할지 고민도 했습니다.
그럼에도 2018년의 글에 보내 주신 관심에 용기를 얻어서 이 글을 발행합니다. 최근의 경험을 나누고 미래를 함께 상상해 보는 일이 지금 시점에는 더 의미가 있다고 생각합니다. 이 글을 목적지가 명확한 안내서보다는 격변기의 스냅샷 정도로 봐 주셨으면 합니다.
주요 질문과 답변
설문을 통해 들어온 질문들을 비슷한 주제로 모아서 답변을 정리했습니다.
[AI 시대와 개발자]
가장 비중이 높은 질문 유형이었고 근본적인 주제이기도 합니다. 이 질문에 먼저 답하지 않고서는 다른 이야기를 풀어 가기가 어려웠습니다.
AI 시대에 개발자의 역할은 어떻게 달라졌을까요?
누군가는 AI를 인터넷이나 전기, 불에 비견될 정도의 혁명이라고 말합니다.[1] 2025년부터는 그 주장이 과장이 아니라고 느낍니다. 제가 프로그래밍을 시작한 1989년 이후로 '코딩’이라는 활동에 가장 큰 변화가 왔습니다. AI 코딩 도구가 코드를 추천해 주는 역할에서 나아가 소스 작성, OS 명령 실행 등 사람의 실질적인 대리로 행동합니다.
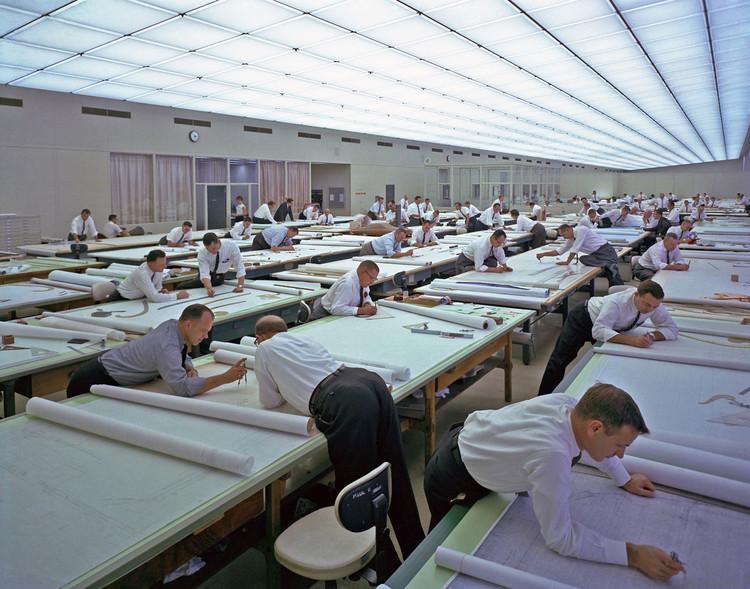
역사를 돌아보면 기술이 발전하면서 지식 근로자가 하는 일은 이전 시대 관리자의 역할에 가까워졌습니다. 1980년대에 개인용 컴퓨터가 보급되기 전까지 지식 근로자의 작업 공간은 종이였고, 수기로 정보를 처리하는 일에 쓰는 시간의 비중이 컸습니다. AI 시대 전에도 계산, 정보의 형식 변환과 취합 등 컴퓨터가 하는 일의 범위는 꾸준히 늘어 왔습니다. 과거의 실무 일부를 컴퓨터가 하게 되면서 말단의 지식 근로자도 영향력이 큰 의사결정에 많이 관여할 수 있게 되었고 권한도 커졌습니다.
CAD 도입 전 General Motors의 기술자들이 작업하는 모습 (이미지 출처: ArchDaily)
이제는 조직의 말단 작업자는 AI이고 모든 개발자는 AI 팀의 관리자가 되었습니다. 사람은 여러 AI 에이전트에게 업무를 지시하고 결과에 피드백을 줍니다. 아래에 나열한 일들은 전통적인 관리자의 역할이기도 하지만 '작업자’를 'AI 에이전트’로 바꿔서 읽어 본다면 이제는 모든 개발자가 하는 일입니다.
다수의 작업자에게 목표와 배경, 추구하는 가치, 평가 기준을 제시한다.
작업자의 정보 탐색 비용을 줄여 준다.
참조할 정보가 어디에 있는지 알려 준다.
작업자별 역할을 명확히 정의하여 할 일을 분배한다.
작업자별 장점과 투자액(과금액) 수준을 고려하여
각자의 작업에 집중할 수 있도록, 컨텍스트가 과도하게 넓어지지 않고 컨텍스트 전환이 최소화되도록
의사결정자와 작업자 간의 효율적인 피드백 사이클을 구축한다.
관리 업무의 멀티태스킹도 개발자가 적응해야 할 환경이 되었습니다. 에이전트에게 많은 일을 맡기려면 다수의 작업자가 병렬로 일을 진행할 수 있도록 지시를 내리고 결과물에는 빠른 피드백을 주어야 합니다. 작업자마다 컨텍스트를 좁혀 줄수록, 넓은 범위의 맥락을 머리에 올려 두고 빠르게 전환해야 하는 부담은 사람에게 더 크게 돌아옵니다. AI 에이전트와 일하는 형태는 여러 메신저 창을 왔다 갔다 하면서 다수와 병렬로 대화를 이어 가는 관리자의 모습과도 닮아 갑니다. 어떤 순간에는 화면을 어지럽게 전환하면서 게임 유닛에게 작업 지시와 확인, 판단을 쉴 틈 없이 하는 프로게이머와도 유사하게 느껴집니다.
정보를 찾을 수 있는 연결 체계와 필요한 권한을 제공하여 에이전트가 막힘없이 일하도록 하는 일이 중요해지고 있습니다. 부작용을 줄이며 코드를 고치고 빠르게 피드백을 받을 수 있는 아키텍처와 워크플로를 설계하는 일도 핵심 업무가 됩니다. 개발자 경험(Developer Experience)뿐만이 아니라 AI 에이전트 입장에서 얼마나 일을 하기 쉬운지가 생산성을 좌우하게 됩니다. 이는 개발 리더가 다른 개발자들이 일하기 좋은 코드 구조와 작업 절차를 잡아 주는 일과도 유사합니다. 아키텍처와 기술 스택, 구현 방식 같은 기술 의사결정은 여전히 중요합니다. 합리적으로 결정하면 AI 에이전트가 더 안전하고 빠르게 일하고, 그렇지 못하면 오히려 기술부채를 쌓습니다. 예를 들면 모듈 경계가 분명하면 에이전트는 고칠 범위를 좁게 잡지만, 경계가 흐리면 비슷한 코드를 여기저기 복제합니다.
더 상위 수준의 설계까지 AI가 맡는 다음 단계도 이미 시작되고 있습니다. 최근의 코딩 에이전트는 다른 에이전트에게 일을 분배하는 리더 역할까지도 수행합니다. 아키텍처도 AI가 제안하는 방향을 개발자가 수용하거나 근거로 드는 빈도가 높아지고 있습니다. 리더와 아키텍트 역할까지 AI가 가져간다면, 조직 수준의 투자와 리스크 감수를 결정하는 일이 사람의 역할로 남을 것입니다. 앞에서 모든 개발자가 AI 팀의 관리자가 되었다고 말씀드렸는데, 이 단계까지 가면 모든 회사 구성원이 한 번 더 승진을 하는 셈입니다. 조직도상의 개인 기여자도 일하는 형태로는 여러 실무팀의 리더들의 리더가 됩니다. 현실 세계 조직도상의 조직장은 리더들의 리더들의 리더가 되니, 적어도 소기업 경영진의 관점에서 생각하고 결정하는 빈도가 높아질 것 같습니다. 경영진이 투자 대비 사업 성과를 평가하듯, AI 사용료에서 종량제 비중이 높아지면서 한 번의 세션, 한 번의 프롬프트가 주는 부가가치에도 이전보다 신경을 쓰게 됩니다.
AI는 지치지 않고 병렬로 일하는 대신 세션이 끝나면 맥락을 잊습니다. 이처럼 사람과 지능의 성격이 다르니 관리하는 방법도 달라야 합니다. 그 차이를 전제하더라도, 관리자의 일하는 방식에 하나의 정답이 없다는 점은 AI와 일하는 방식을 고를 때도 참고가 됩니다. 개발을 모르는 팀장도 팀원들에게 맡기면 결과물은 나오고, 몰라서 더 많이 위임하기에 생기는 장점도 있습니다. 반면 개발을 잘 아는 팀장은 처음부터 올바른 방향을 지시해 시행착오를 줄이기도 합니다.
AI 에이전트와 일할 때도 코드를 아는 개발자는 상황에 따라 마이크로매니징과 큰 단위의 위임 중에서 고를 수 있습니다. 이렇게 현미경과 망원경을 오가면서 AI를 감독할 수 있다면 특성과 민감도가 다양한 작업을 안정적으로 수행할 수 있을 것입니다. 제가 아는 뛰어난 개발자 중에서는 수 시간 동안 에이전트가 실행할 업무 정의를 잘하시는 분도 있습니다. 프롬프트를 내린 후에 중간에 나오는 메시지를 하나하나 다 보시면서 에이전트가 일을 어긋나게 수행하는 순간을 바로 잡아내시는 분도 있습니다.
AI에게 맡겨도 되는 부분과 개발자가 직접 해야 하는 부분이 있을까요?
실행 능력만 놓고 보면 이제는 AI가 개발자가 하는 대부분의 일을 할 수 있고, 더 잘하는 일도 많습니다. 아무리 AI가 발전해도 할 수 없는 일이 무엇일지를 생각해 보면 이 질문에 오래가는 답을 찾을 수 있습니다. 사람만이 '책임’을 질 수 있습니다. AI 에이전트가 모든 작업을 다 해 준다고 해도 그 소프트웨어를 사용자가 쓰게 하는 결정은 사람이 내립니다. 그로 인해 사용자에게 미친 영향의 책임은 AI에게 지시를 내리고 그 결과물을 최종 승인한 사람에게 돌아갑니다.
AI 생성 이미지
누구나 코드를 만들 수 있게 된 시대에 '개발자’라는 명칭이 앞으로도 쓰인다면, 민감한 시스템의 운영 환경에 코드 배포를 승인하는 사람이라는 의미가 가장 크지 않을까 합니다. 그렇다면 문제를 알아보고 예방할 수 있다는 믿음을 주는 사람에게 그런 권한을 부여하고 '개발자’라고 부를 가능성이 높습니다. 그런 믿음을 주려면 코드의 동작 결과를 검증하고 보장하는 장치와 활동이 더 중요해집니다. 코드 리뷰와 테스트 자동화가 대표적인 예입니다.
검증도 1차적으로는 AI에게 맡기는 방향으로 가고 있습니다. AI 에이전트의 불확정성을 줄이는 하네스(harness) 기법들도 대부분 리뷰와 테스트 지시를 포함합니다. 그래서 사람이 세세하게 코드를 들여다보는 일은 구시대적인 방식이라고 보는 분위기도 업계 일부에는 있습니다.
하지만 모든 소프트웨어의 모든 코드를 AI에게만 맡기고 사람이 들여다보지 않고 개발할 수는 없다고 생각합니다. 꼼꼼한 지시와 하네스, 가드레일을 통해 AI가 만든 코드를 그대로 배포해도 문제가 없는 소프트웨어도 분명히 있을 것입니다. 그러나 큰 책임이 따르는 소프트웨어일수록 사람이 코드를 살펴볼 가치가 커집니다. 예를 들면 수억 원의 돈을 처리하는 배치 잡에서 AI가 만든 코드가 완벽하다고 가정하고 배포하는 행위는 기댓값이 크게 마이너스인 도박입니다.
그 이유는 LLM(대규모 언어 모델)의 불확정성과 개발 과정에서 의존하는 환경의 한계 때문입니다. LLM의 결과물은 확률 분포를 따르기 때문에 같은 지시에도 다른 코드가 나올 수 있고 문제를 일으키는 코드가 섞일 가능성이 있습니다. AI가 오류 메시지를 보고 고치는 피드백 루프가 잘 작동할 때 신뢰할 만한 코드가 나오는데, 그 루프는 주로 개발 환경 안에서 일어납니다. 대형 시스템일수록 개발 환경과 운영 환경의 트래픽, 데이터 용량, 실행 경로의 다양성은 차이가 큽니다. 그래서 에이전트가 개발 환경에 의존해서 통과시킨 코드가 운영 환경에서 성능 지연과 메모리 초과, 데이터 오염 같은 문제를 일으키지 않는다고 보장할 수는 없습니다. 그렇다고 운영 환경의 데이터로 실험할 수 있는 범위는 제한적입니다. AI 에이전트가 작업 중인 코드로 운영 DB의 데이터를 오염시키거나 부하를 일으킬 가능성은 차단해야 하기 때문입니다. 시스템이 다루는 분야의 지식이 깊고 운영 환경에서 생기는 문제를 경험한 개발자는 개발 환경의 피드백 루프에는 잡히지 않는 위험을 방어합니다.
보안 측면에서는 AI의 자체 검증과 사람의 리뷰 외에도 다각도의 검증을 거치지 않으면 안심할 수 없게 되었습니다. AI는 공격자에게도 강력한 무기입니다. 오픈소스 라이브러리에서 취약점을 찾고 공격 코드를 만드는 비용이 낮아지면서, 취약점이 공개된 뒤 실제 공격으로 이어지기까지의 시간도 짧아지고 있습니다. 해커는 AI를 써서 알려진 취약점을 빠짐없이 공략하고 여러 취약점을 조합해 공격합니다. AI가 만든 코드가 늘 취약점이 패치된 버전의 라이브러리에 의존한다는 보장은 없습니다. 새 취약점이 공개되면 어제 안전했던 코드도 오늘 위험해질 수 있습니다. 그래서 의존성 취약점 점검, 정적 분석, 보안 관점의 AI 리뷰처럼 여러 겹의 검증 장치를 갖추고, 새 취약점이 공개되었을 때 빠르게 대응할 수 있는 체계를 만들어야 합니다.
직접 짜지 않은 대량의 코드를 빠르고 정밀하게 이해하기는 어렵습니다. 그래서 AI가 만든 코드를 어디까지 세세하게 봐야 할지는 시스템, 모듈의 특성과 개발 단계에 따라서 판단해야 합니다. 예를 들면 Claude Code를 만드는 Anthropic 팀은 분류기를 써서 풀 리퀘스트의 위험도를 세 단계로 나눕니다. 문서나 플래그로 꺼 둔 추가 기능처럼 위험이 낮은 변경은 자동 리뷰와 보안 검사만 통과하면 사람의 승인 없이 병합하고, 보통의 변경은 한 명, 위험이 가장 높은 변경은 두 명의 사람이 승인합니다. 결제나 자동 업데이트, CI 워크플로처럼 민감한 영역은 분류 결과와 관계없이 반드시 사람이 승인합니다. 간소화된 승인 절차는 저장소별로 신뢰할 수 있다고 등록된 개발자에게만 허용됩니다.[2] 에이전트의 승인은 사람의 승인으로 인정하지 않습니다. 에이전트에게 변경을 지시한 사람이 리뷰어 한 명으로서 책임을 집니다. 이와 같은 세밀한 승인 정책이 업계 전반으로 퍼지면서, 이를 더 원활하게 적용하기 위해 사람이 꼼꼼하게 봐야 할 코드를 별도의 모듈이나 소스 저장소로 분리하는 설계 패턴도 정밀하게 논의될 것으로 예상합니다. 운영 환경의 실행 조건을 테스트 시나리오로 완벽하게 재현할 수 있는 모듈은 철저한 테스트로 안정성을 보증하는 전략을 펼칠 수도 있습니다. 반면 어디서 어떤 방식으로 호출될지 모르는 공통 모듈에 가까울수록 개발자가 코드를 세세하게 이해할 필요성이 높아집니다. 어떤 모듈이라도 유지보수 비용을 줄이는 내부 구조는 사람이 신경 써야 합니다.
개발자라면 누구나 담당하는 시스템에서 이 질문의 답을 구체적으로 요구받을 것입니다. 사람의 역할을 정하는 결정도 사람의 핵심 업무입니다. 그런 결정을 위한 기준은 개인적이기보다는 조직 수준에서 합의되어야 안정적으로 지속됩니다. 현장마다 배포 속도를 중시하는 쪽과 안정성을 중시하는 쪽이 부딪히겠지만, 균형점을 찾아가기 위한 충돌을 회피하려는 유혹을 경계해야 한다고 생각합니다.
AI 시대 개발자는 어떤 역량이 필요할까요?
앞선 답변을 통해 개발자는 개발할 방향을 지시하고 책임지는 역할로 바뀌어 간다고 말씀드렸습니다. 그래서 방향을 결정하는 사람에게 필요한 역량이 AI 시대 개발자에게 기대되는 역량과도 연결됩니다. 크게 두 가지로 나눠서 생각해 봤습니다.
사람이 더 잘하는 소통과 정보 수집
AI는 사람이 결정한 방향을 증폭합니다. 적시의 소통이 없다면 AI로 만든 개인의 결과물은 더 빠른 속도로 지향점과 어긋나게 됩니다. AI로 업무 실행이 빨라지면서 사람이 소통해서 내리는 결정이 더 큰 병목이 되었습니다. 방향이 어긋난 채로 일이 진행될 때 낭비되는 시간과 토큰도 늘었습니다. 그러니 방향을 맞출 때는 가장 빠르게 피드백을 받을 수 있는 수단을 고르는 판단이 중요합니다. 그 수단은 문서로 쓴 스펙일 수도, AI로 금방 만든 프로토타입일 수도, 한 장의 다이어그램일 수도 있습니다. 코드가 가장 빠른 소통 수단일 때도 있습니다. 적합한 수단과 주기, 표현 방식은 상대에 따라 다릅니다. 지식의 양과 처리 속도는 AI가 압도하고 있으니 사람에게는 더 많이 아는 능력보다 상대의 입장을 헤아리는 공감력이 더 귀한 역량이 되어 가고 있습니다. 공감 없이 소통하고 결정하면 갈등이 되풀이되고, 사람마다 추구하는 방향은 더 엇갈립니다.
그런데 AI 시대에는 공감력 같은 사회적 능력이 오히려 퇴화할 수 있습니다. AI는 사용자의 말에 비판 없이 동조하고 비위를 맞춰 주는 쪽으로 반응하기 쉽습니다. 사람과의 관계에는 시간과 인내, 서로 맞춰 가는 조율이 필요하지만, AI는 그런 마찰 없이 즉각적인 만족을 줍니다. 그런 대화에 익숙해지면 의견이 다른 사람과 부딪히는 불편함을 피하게 되고, 갈등을 조율하는 능력도 약해질 수 있습니다.[3] 사회적 능력을 키우려면 그 불편함을 피하지 않고 사람과 직접 부딪히는 경험을 의식적으로 이어 가야 합니다.
사람과 직접 부딪혀야 할 이유는 정보 수집에도 있습니다. AI가 알지 못하는 정보를 다른 사람들에게서 끌어내는 일은 사람이 해야 합니다. 소프트웨어의 요구사항은 사람들의 머릿속과 대화 속에 모호한 형태로 흩어져 있습니다. AI가 사람에게 요구사항을 묻는 '스펙 인터뷰’를 대신해 주기도 합니다. 그러나 AI와의 상호작용만으로는 끌어내기 어려운 요소도 있습니다. 조직 내의 암묵적인 전제나, 이해관계자 사이의 온도 차, 사람을 만났을 때 떠오르는 영감 같은 것들입니다. 사람마다 미래에 대한 기대와 예측이 다르고, 우선시하는 가치가 다르기도 합니다. 그렇게 끌어낸 모호한 맥락을 명확한 지시로 바꾸어 내는 일이 개발자의 핵심 역량입니다.
LLM의 학습 데이터에 없는 정보를 최대한 많이 기록하고 연결해 AI 에이전트가 알 수 있게 하는 일도 병행해야 합니다. 다만 우리 뇌에 있는 모든 정보가 완벽하게 AI 에이전트에게 전달되는 일은 가능하지도 효율적이지도 않습니다. 사람의 뇌는 약 20W로 동작하면서 실세계 정보를 수집하고 해석합니다.[4] 사람이 접하는 모든 시청각 정보를 웨어러블 기기로 수집하여 AI에게 전달하는 날이 올 수도 있습니다. 그러나 수많은 사람의 하루 전체에서 나오는 음성과 영상을 AI가 빠짐없이 해석하려면 막대한 연산량과 전력이 필요합니다. 그래서 한동안은 함께 일하는 사람이 어떤 사람인지는 AI보다 내가 더 입체적으로 알고 있을 가능성이 높습니다. 동료의 표정과 평소 나눈 대화를 떠올리며 회의 때 나온 주장을 섬세하게 해석할 수 있는 것도 그 덕분입니다. 그런 사람의 장점을 정보 수집 활동에서도 잘 조화시켜야겠습니다. 회의 녹음을 AI가 글자로 옮기고 사람이 미세한 어조를 다듬어서 AI가 참조할 수 있는 위치에 올리는 방식도 그 예입니다.
8년 전 '백엔드 개발자를 꿈꾸는 학생개발자에게' 글에서 강조했던 '용어의 범위’도 AI 시대에 더 중요해졌습니다. 특정 조직에서만 특이하게 쓰이는 용어는 AI가 잘못 해석하기가 쉽습니다. 그래서 핵심 용어의 정의와 범위를 팀이 함께 맞추고 문서로 기록해 두는 일은 AI와의 협업에서도 생산성을 좌우하는 기반이 됩니다.
특정 분야의 높은 기준과 조합
진입 장벽이 낮다고 해서 모든 사람이 잘하게 되거나 가치가 없는 활동이 되지는 않습니다. 예를 들면 글쓰기는 한글이 널리 보급된 뒤로 진입 장벽이 낮은 활동이었습니다. 지금 오타 없이 논리적 정합성에 맞게 글을 쓰는 능력은 AI가 사람보다 뛰어납니다. 그럼에도 여전히 글을 잘 쓰는 사람이 창출하는 가치가 있습니다. 독자와 목적에 맞게 문장과 단어를 쓰는 안목은 사람마다 차이가 크기 때문입니다. 개발에서도 그런 안목으로 '보편적인 수준보다 더 높은 기준’을 AI와 다른 사람에게 제시할 수 있는지가 전문성을 판가름한다고 생각합니다.
저는 백엔드 개발자 경험으로 운영 서버에 배포할 코드에는 AI로 코드를 만드는 기획자보다 더 높은 기준을 적용합니다. AI가 괜찮다고 본 성능 기준이 저에게는 충분하지 않았던 경우가 있었습니다. 예를 들면 AI는 목록 한 건마다 DB를 다시 조회하는 N+1 쿼리를 두고 운영 환경에서 문제가 없는 수준이라고 주장했지만, 배포될 환경을 고려했을 때 저는 그 기준을 받아들일 수 없었습니다. 그렇다고 처음부터 그런 높은 기준에 맞춰 코드를 만들어 주는 에이전트가 더 좋은 것은 아닙니다. 높은 트래픽을 수용해야 할 시스템의 기준에 맞춰서 모든 코드를 만든다면 오버엔지니어링이자 토큰 낭비이기 때문입니다. 몇천만 사용자가 연간 수십조 원의 상품을 구매하는 시스템에서 필요한 기준은 AI에게 알려 줘야 그에 적합한 코드가 나옵니다.
이미 현장에서는 AI가 사람보다 더 권위 있는 존재로 받아들여지기도 합니다. 완벽한 정답은 아니더라도 특정 개인의 이해관계나 감정에서 벗어난 객관적인 존재로 여겨지기 때문입니다. 그래서 AI의 결과물보다 높은 기준을 주장하려면 그 기준으로 다른 사람을 설득할 수 있는 근거도 함께 갖추어야 합니다.
그런데 전문가의 기준조차도 스킬(skill)이나 지식 DB 형식으로 AI에게 쉽게 전이됩니다. 그래서 '여러 관점의 높은 기준을 특정 목적에 맞게 조합하고 선택하고 결정할 수 있는 역량’까지 있어야 AI의 초안에서 개선점을 발견하고 더 나은 결과물을 이끌어 낼 수 있습니다. 예를 들어 캐시는 성능 관점에서는 좋은 선택이지만 데이터 정합성 관점에서는 위험할 수 있습니다. 이런 종합적인 판단을 AI가 초안에 담기 어려운 이유는 판단에 필요한 정보 중에 찾고 정리하는 비용이 크거나 우선순위를 매기기 어려운 것이 있기 때문입니다. 앞서 말씀드린 조직의 암묵적인 전제나 이해관계자 사이의 온도 차가 그런 정보이고, 그것을 끌어내는 사람이 결국 조합의 기준도 정합니다.
AI 시대에 더 이상 불필요한 지식은 어떤 것일까요?
AI 시대 전에도 기계와 가까운 레벨의 지식을 몰라도 일단 실행되는 프로그램을 만들 수는 있었습니다. 예를 들어 CPU나 GPU의 원리, 한글 한 글자가 메모리에 몇 바이트로 저장되는지는 기술의 추상화 계층이 대신 처리해 주므로 평소에는 신경 쓰지 않아도 됩니다. AI는 실행되는 프로그램을 만드는 데 필요한 지식의 최소 수준을 더 낮추고 있습니다.
그렇다고 '실행되는 프로그램 작성에 필수가 아닌 지식’을 '필요 없는 지식’으로 미리 선을 긋는 태도는 권하고 싶지 않습니다. 앞에서 말씀드린 높은 기준을 충족해야 하는 코드나 큰 책임이 따르는 코드를 승인하는 자리에서는 실행되는 프로그램을 넘어 문제없는 프로그램인지 판단하는 데 필요한 지식까지 있어야 하기 때문입니다.
물론 AI 모델이 빠르게 발전하면서, 최상위 LLM을 쓴다면 기반 기술과 원리를 잘 모르는 사람도 숙련된 개발자의 역량을 상당 부분 따라잡을 수 있게 되었습니다. 그러나 실무에서 늘 최상위 모델을 마음껏 쓸 수 있다는 보장은 없습니다. 모델의 가격 대비 성능은 빠르게 좋아지고 있지만, AI 에이전트가 확산되면서 회사가 AI에 쓰는 지출은 계속 늘고 있습니다. 지출이 커질수록 투자 대비 효과를 더 엄격하게 평가하므로, 모든 작업에 최상위 모델을 쓸 만큼 사용 한도를 넉넉히 주는 회사는 많지 않습니다. 금융이나 공공처럼 규제가 강한 분야에서는 보안 요건 때문에 코드나 데이터를 외부 모델에 보내지 못하고 사내에 직접 띄운 작은 모델만 써야 하는 환경도 있습니다. 호출 한도나 LLM 공급사의 장애 때문에 내부망이나 개인 장비에 설치한 모델에 의존해야 하는 순간도 생깁니다. 가용한 모델의 수준이 환경과 시점마다 달라지더라도, 기반 기술과 원리를 깊이 아는 사람은 안정적으로 코드를 관리할 수 있습니다.
자신이 모른다는 사실을 아는 메타 인지, 지적 겸손과 모르는 지식을 배우는 습관은 여전히 중요합니다. 특히 AI가 만든 산출물을 본인의 지식과 역량이라고 착각하는 태도는 경계해야 합니다. AI의 도움으로 성과가 올라도 자기 평가는 그만큼 정확해지지 않는다는 연구도 있습니다. 논리 문제를 AI와 함께 푼 참가자들은 점수가 실제로 올랐지만 자신의 성과는 그보다 더 높게 평가했고, 스스로 AI를 잘 안다고 평가한 사람일수록 과신이 심했습니다.[5] 참가자 대부분은 문제를 AI에게 그대로 넘기고 답을 검증하지 않았습니다. 사고 과정까지 AI에게 맡기는 일이 늘어나는 요즘, 스스로 이해할 필요가 생긴 지식을 끈기 있게 파고드는 지적 지구력은 점점 더 희소한 가치가 될 것입니다.
그렇게 파고드는 학습은 검색하고 읽는 데서 그쳐서는 안 됩니다. 정보를 능동적으로 해석해서 자신의 지식 체계에 연결해 저장하고, 필요할 때 인출해서 자신만의 언어로 말하거나 글로 쓰는 과정까지 거쳐야 내가 응용할 수 있는 지식이 됩니다.[6] 이 과정을 AI에게 다 맡기면 편하겠지만 학습이라고 할 수 없습니다. 스스로 해석하고 인출하는 불편함은 감수해야 합니다.
'넓고 얇은 지식’과 '좁고 깊은 지식' 중 어떤 쪽이 더 중요할까요?
'넓고 얇은 지식’과 '좁고 깊은 지식’이라는 이분법 자체를 다시 생각해 보는 것이 좋겠습니다.
실무에서 지식은 그 자체가 목적이 아니라 결국 판단을 위한 수단입니다. 판단에 필요한 지식을 균형 있게 갖추는 것이 중요한데, 세부적인 지식의 빈 곳은 이제 검색이나 AI를 통해 어느 정도 메울 수 있게 되었습니다. 그렇다면 사람의 머릿속에 올라와 있어야 하는 지식은 '지식의 연결 지도’라고 생각합니다. 본인이 무엇을 모르는지를 알기 위해서는 빈 곳을 찾아갈 수 있는 연결점이 필요합니다. 다른 관점의 정보들을 연결하여 새로운 판단으로 만들어 내는 사고도 그 경로가 머릿속에 바로 떠 있어야만 일어납니다.
머릿속에 지식이 있어야 하는 이유는 '즉시 대응’이나 '백업’의 의미에서도 찾을 수 있습니다. 어디서나 AI에게 물어볼 수 있는 시대이지만, 중요한 회의 때 즉각적인 표현과 판단마다 AI에게 의존할 수는 없습니다. 대면 소통으로 바로 판단하고 의견을 줄 수 있는 사람은 의사소통의 속도를 높일 수 있습니다. 긴급한 장애가 났는데 AI의 도움을 받기 어려운 순간도 찾아옵니다.
'T자형 인재’가 필요하다는 이야기는 적어도 1990년대 초부터 나왔습니다.[7] 특정 분야의 깊은 전문성(세로축)과 다양한 분야의 넓은 이해 및 소통 능력(가로축)을 동시에 갖춘 융합형 인재를 가리킵니다. 그런데 여러 기준을 조합해야 하는 지금은 T 하나로 멈추기보다, 깊은 축을 시간을 두고 하나씩 늘려 가는 파이형이나 문어 다리형이 더 유리하다는 생각까지 듭니다. 잘 모르는 분야의 기준은 AI에게 물어볼 수 있지만, 기준끼리 충돌할 때 어느 쪽을 택할지는 양쪽을 깊이 아는 사람이 더 잘 판단하기 때문입니다.
출발점은 한 분야의 깊이입니다. 적어도 한 분야에서는 AI가 내놓은 결과물을 비판할 수 있을 정도의 깊이가 필요합니다. 앞서 역량 질문에서 전문성을 판가름한다고 말씀드린 '보편적인 수준보다 더 높은 기준’도 이런 깊이가 있어야 세울 수 있습니다.
결국 지식의 분포는 '넓이’와 '깊이' 중 하나를 고르는 문제가 아니라, 판단에 필요한 여러 분야를 각각 필요한 깊이만큼 갖추는 다차원의 문제에 가깝다고 생각합니다.
소프트웨어 개발의 미래를 어떻게 전망하시나요?
AI의 발전 속도가 빨라서 몇 년 뒤를 예측하기가 어렵습니다. 1년 전만 해도 AI는 상세한 지시 없이는 만족스러운 결과물을 내놓지 못하는 때가 많았습니다. 그런데 이제는 모호한 지시를 던지면 AI가 먼저 되물어 가면서 일을 해 줍니다. 이런 변화가 어디까지 이어질지 가늠하기 어렵습니다.
앞에서 말씀드린, 큰 책임이 따르는 기능은 명확한 소스 코드로 확인해야 한다는 저의 믿음도 언제까지 유효할지 모르겠습니다. 한 세대 전의 개발자들이 'C나 어셈블리어를 알아야 깊이 있는 개발자’라고 믿었던 것과 유사하게 취급될지도 모르겠습니다. 격변기 한가운데 있으면서 무엇이 앞으로도 변하지 않을 원리이고 무엇이 과거의 토템이 될지 구분하기란 어렵습니다.
실제로 AI가 자연어 스펙 문서에서 바로 기계어나 어셈블리어를 생성하면 되니, 소스 코드는 사람이 읽지 않는 지금의 바이너리처럼 된다는 주장이 있습니다.[8] 더 나아가 소스 코드를 잃어버려도 스펙만 있으면 재생성하면 되니, 코드의 가치는 0으로 수렴한다는 주장도 나옵니다.
우선 소스를 생성하는데 들어가는 시간과 비용 측면에서 저는 이런 주장들에 공감하기 어렵습니다. 큰 코드베이스를 다룰 때에는 Kotlin이나 Swift 같은 언어도 컴파일이 느리다는 평가를 받습니다. 자연어를 LLM이 해석해서 실행 가능한 코드로 바꾸는 과정은 그런 컴파일보다도 느립니다. 자연어 스펙은 소스 코드보다 구조의 경계가 모호해서, 고친 부분과 그 영향을 받는 부분만 골라 다시 해석하기가 어렵습니다. 스펙을 고칠 때마다 LLM이 전체까지는 아니더라도 많은 부분을 다시 해석하는 과정이 컴파일러의 자리를 대신한다면 몇백 배 이상 더 느려질 수도 있습니다. 소스 생성에 드는 시간과 토큰, 에너지 비용은 0이 아닙니다. 재생성한 소스 코드에 오류가 없다고 보장할 수도 없습니다. 자연어 스펙은 여러 가지로 해석될 여지가 있어서, 같은 스펙으로 재생성해도 이전과 다른 해석을 따른 코드가 나올 수 있습니다. 운영환경에 맞춰서 성능최적화를 한 쿼리처럼 정제된 세부 구현은 재생성한 코드가 그대로 재현하지 못할 가능성이 큽니다. 그런 세부 사항까지 모두 문서로 남겨 둔다면, 자연어는 코드보다 축약성이 떨어지므로 스펙 문서가 코드만큼 길어질 수도 있습니다.
표현의 명확성 면에서도 자연어 스펙이 코드의 모든 역할을 대체하는 것은 과도한 기대입니다. 미국에서는 법 조항의 쉼표 하나 때문에 소송이 벌어졌습니다. 메인주 법에서는 초과근무 수당을 주지 않아도 되는 업무의 마지막 항목이 'packing for shipment or distribution’라고 나와 있었습니다. 'shipment’와 'or' 사이에 쉼표가 없어서 '유통’이 별도의 면제 업무인지, '배송이나 유통을 위한 포장’이라는 한 업무의 일부인지 해석이 나뉘었습니다. 두 해석을 조건식으로 옮기면 다음과 같이 괄호의 위치만 다릅니다.
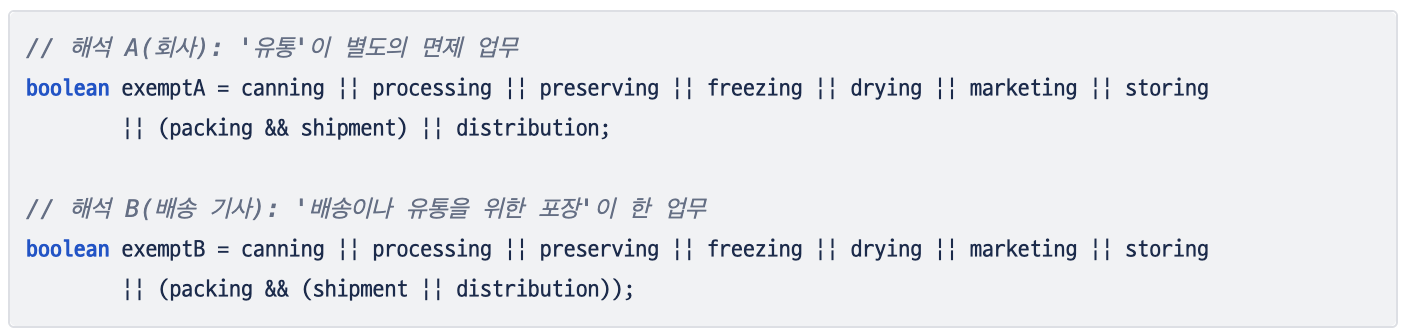
포장은 하지 않고 유통만 하는 배송 기사는 해석 A에서는 면제 대상(true)이지만, 해석 B에서는 초과근무 수당을 받아야 하는 대상(false)입니다. 항소법원은 2017년에 조항이 모호하다고 보고 유통 업무를 하는 배송 기사들의 손을 들어 주었습니다.[9] 법 조문은 전문가가 정밀하게 쓰려고 노력하는 문장임에도 이런 일이 생겼습니다. 에츠허르 다익스트라(Edsger W. Dijkstra)는 1970년대 후반에 프로그래밍 언어와 같은 형식 언어로 쓴 글이 자연어로는 피할 수 없는 논리적으로 성립하지 않는 진술을 걸러 내는 효과적인 도구라고 했습니다.[10] 이 주장은 아직도 유효합니다.
저도 커머스 시스템 개발에 참여하면서 복잡한 정책을 자연어로 정리하는 일이 쉽지 않음을 실감했습니다. 사람 사이의 소통을 위해서 때로는 표와 다이어그램, 정제된 단어로 스펙을 표현해야 합니다. 큰 의도와 배경, 큰 논리 흐름은 자연어 문서로 잘 보존해 둘 가치가 있습니다. 그러나 앞에서 예로 든 성능 최적화 같은 구현 세부 사항까지 자연어에 의존하는 것은 프로그래밍 언어라는 좋은 도구를 두고 적합하지 않은 표현 수단을 쓰는 일입니다. 사람과 기계가 함께 이해하는 명확한 표현 방식으로서 소스 코드는 앞으로도 가치 있는 자산이라고 생각합니다.
AI 시대에도 백엔드 개발자 직군이 유지될까요?
AI 에이전트로 인해 특정 기술 스택의 진입 장벽은 낮아졌습니다. 개발 직군이 아니더라도 문제 해결 의지가 강한 분들이 프로그램을 만들고 배포하는 모습도 자주 보입니다. 그래서 특정 기술 스택이나 아키텍처의 일부 레이어를 다룬다는 사실만으로는 차별화된 전문성과 경력으로 인정받기 점점 더 어려워지리라 예상합니다. '백엔드/프런트엔드' 구분 대신 '프로덕트 개발자’로 역할이 통합되고 있다는 소식도 업계 내에서 들려옵니다.[11] 이 글의 전편 제목은 '백엔드 개발자를 꿈꾸는 학생개발자에게’였지만 이제는 '백엔드' 단어를 제외했습니다. 학생분들도 자신의 진로를 특정 레이어나 스택으로 제한하지 않았으면 하는 바람에서였습니다.
뒤돌아보면 과거에도 개발팀 안의 역할이 기술 스택으로 명확히 구분되는 것은 아니었습니다. 백엔드 개발이 범위가 넓은 탓도 있었지만, 개발 업무의 특성상 경계를 넘나드는 사람이 항상 필요했기 때문이기도 합니다. 개발팀은 포지션의 경계가 명확한 야구팀보다는 필요에 따라 빈 역할을 메워야 하는 축구팀이나 농구팀에 가까웠습니다. 최고의 공격수 손흥민 선수도 경기 양상에 따라서 후방으로 내려와 수비를 합니다. 골키퍼가 없을 때 몸을 날려서 공을 막는 수비수가 개발팀에는 항상 필요했습니다.
그럼에도 포지션을 구분한 것은 전문 분야가 세분화되고 지식의 양이 늘어 한 사람이 모든 기술을 단기간에 익히기는 어려워졌기 때문이었습니다. 포지션에 안 맞는 업무를 분장하는 것이 혹시나 팀 구성원의 향후 경력에 단점이 되지 않을까 하는 우려도 컸습니다. AI 덕분에 새 기술을 익히는 비용이 낮아지고 특정 스택의 경험이 차별화된 경력으로 인정받기도 어려워지면서 이 두 가지 이유는 모두 약해졌습니다. 그만큼 개발자가 주 영역을 넓혀 공동의 목표에 기여하리라는 기대치는 높아졌습니다. 그렇다고 특정 분야의 깊이 있는 전문성의 쓸모가 사라지지는 않습니다. 앞서 말씀드렸듯이 적어도 한 분야에서는 AI의 결과물을 비판할 수 있을 정도의 깊이가 여전히 필요합니다.
풀스택 개발자로 직무가 바뀌면 연봉이 올라가거나 보너스 같은 게 있는지 질문하신 분도 있었습니다. 풀스택 개발자라는 직무가 따로 정의되어 있지는 않고, 풀스택 개발자인지의 기준도 모호한 면이 있습니다. 프런트엔드 개발자라는 직무가 따로 정의되기 전에는 한 사람이 화면과 서버를 함께 다루는 것이 당연했고, 그렇다고 그 사람을 풀스택이라고 부르며 더 보상하지는 않았습니다. 직무의 이름이 바뀐다고 해서 보상이 따라오는 것은 아닙니다. 기술 스택보다는 조직 공동의 목표 달성에 기여하는 바가 컸을 때 보상이 높아질 가능성이 큽니다.
[취업과 진로]
취업 한파를 어떻게 봐야 할까요?
현재 취업 시장 걱정이 설문에서도 많이 나왔습니다. '지금 백엔드 개발자 시장은 포화 상태인가요?', '시장이 너무 안 좋다', '역대급 취업 한파라 스펙과 실력이 상향평준화되었는데 어떤 역량을 키워야 할지 모르겠다’와 유사한 목소리가 반복되었습니다.
2018년의 글에서는 '다양한 도구와 프레임워크가 개발되고 있는 상황에서 백엔드 개발자의 미래는 어떻게 될지 백엔드 개발에 어떤 비전이 있다고 생각하시나요?'라는 질문에 아래와 같이 답변을 드렸습니다.
새로운 도구와 프레임워크로 인해 개발자의 수요나 가치가 하락하지 않을까 하는 우려도 있습니다. 하지만 현장에서 느껴지는 바로는 우리가 해야 할 과제가 늘어가는 속도에 비하면 도구 등에 의한 생산성 증가 속도는 오히려 느리다고 느껴집니다. 새로운 시스템에 대한 수요와 유지 보수할 기존의 시스템도 늘어만 간다는 느낌입니다. 혁신에 투자할 수 있는 여력을 가진 사회라면 S/W개발자에 대한 투자는 계속 증가할 것이라고 전망합니다.
위의 문장을 쓸 때는 과거 프로그래밍 언어의 발전과 같은 예를 생각했습니다. Java나 C# 같은 언어를 쓰면 같은 기능을 어셈블리어의 약 6분의 1 코드로 구현할 수 있습니다.[12] 하지만 지금은 어셈블리어로 코딩을 할 때보다 더 많은 개발자가 일합니다. 그 사이에 소프트웨어 수요가 생산성 개선보다 더 늘었기 때문입니다. 개발에는 구현 외에도 요구사항 정리, 설계, 검증, 운영 같은 할 일이 많기에 구현 생산성이 늘어도 전체 개발 시간을 줄이는 데는 한계가 있습니다.
2018년 답변의 전제였던 '해야 할 과제가 늘어나는 속도가 생산성 증가 속도보다 빠르다’는 관찰은 AI 시대 전에는 유효했습니다. 회사에서 해야 할 일에 비해 필요한 개발자의 손은 항상 부족했습니다. 그러나 AI는 구현뿐 아니라 개발 사이클 전체에 참여하고 있고, 그로 인한 생산 속도 증가는 지금까지 경험하지 못한 도약이기에 과거의 역사만으로는 그 영향력을 판단하기가 어렵습니다. 우리나라에서 소프트웨어로 부가가치를 창출할 수 있는 기회가 얼마나 더 열릴지, 투자를 결정하는 기업과 투자자가 개발자에게 투자해서 얻을 성과를 얼마나 기대할지도 취업 시장에 영향을 미칩니다. 사람 사이의 합의로 큰 의사결정을 내리고, 조직 구조를 바꾸고, 일을 진행하는 속도는 AI의 발전보다 느립니다. 그래서 AI가 가져올 산업과 인력 구조의 변화, 물적·사회적 자본의 투자 방향 변화는 이제 막 시작되는 단계라고 느껴집니다. 큰길이 급커브인 구간에서 먼 거리를 내다보기란 쉽지 않습니다. 그 구간 안에 있는 저도 지금의 취업 한파를 어떻게 봐야 할지 솔직히 모르겠습니다.
당장 구직자 입장에서 어떤 선택과 준비를 해야 할지가 이 질문을 주신 이유일 듯합니다. 지금 '개발자’라고 불리는 직군으로 계속 취업 준비를 하는 것이 좋은 선택일지도 확답을 드리기 어렵습니다. '개발자’라는 이름이 앞으로 어떤 일을 가리킬지부터가 바뀌고 있기 때문입니다. 다만 이 글의 제목에서 '백엔드’를 뺀 것처럼, 더 나아가 '개발자’보다도 스스로의 역할을 넓게 정의해야 포착할 수 있는 기회도 더 많을 것이라고 생각합니다. 이 글을 읽으시며 미래를 상상해 보시고, '나는 어떤 일을, 왜 하고 싶어 하는가’라는 질문을 스스로 반복해서 던져 보시기 바랍니다. 그렇게 내린 결론이라면 진로 선택을 후회할 확률은 줄어들지 않을까 합니다.
어떻게 진로를 결정하고 어떤 회사에 들어가야 할까요?
이 주제로 한 분은 '어떤 회사에 들어가야 할지 모르겠고, 자신은 흥미도 쉽게 변하는데 흥미가 떨어지면 그 일을 하는 것이 고통스럽다’고 하셨습니다. 또 한 분은 '건강, 가족과 연인, 전문성, 수익을 중요하게 여기는데 이 가치관을 개발자로서 삶 속에서 어떻게 실현할 수 있을지' 물어 주셨습니다.
제가 드릴 수 있는 답의 출발점도 앞서 말씀드린 '나는 어떤 일을, 왜 하고 싶어 하는가’라는 질문입니다. 나에게 맞는 회사를 찾으려면 내가 어떤 일을 할 때 시간 가는 줄 모르는지, 무엇을 견디기 힘들어하는지, 어떤 가치를 양보할 수 없는지를 먼저 알아야 합니다. 흥미가 쉽게 변한다는 것도 꼭 단점은 아닙니다. 다양한 분야에 관심을 두어 본 사람은 그만큼 시야가 넓어지고, 그 경험들이 나중에 남다른 방식으로 연결되기도 합니다. 다만 흥미가 떨어질 때마다 처음부터 다시 시작한다면 깊이를 쌓기 어려우니, 흥미의 변화 속에서도 관통하는 자신만의 주제를 찾아보시길 권합니다.
가치관을 일에서 어떻게 실현할지를 생각할 때는, 모든 가치를 동시에 최대로 채워 주는 직장은 없다는 점을 먼저 인정하는 것이 현실적입니다. 질문하신 분이 꼽은 건강, 가족과 연인, 전문성, 수익도 마찬가지입니다. 그 우선순위가 시기에 따라 달라진다는 사실을 받아들이고, 지금의 나에게 더 중요한 요소가 무엇인지를 솔직하게 정의해 본다면 선택지가 더 좁혀질 수도 있습니다. '남들이 좋다고 하는 회사’가 아니라 그 우선순위를 기준으로 고르시면, 적어도 스스로 납득할 수 있는 선택을 하는 데 도움이 됩니다.
현시점 취업을 위해 준비해야 하는 기술 스택이 있을까요?
결론부터 말씀드리면, 모든 신입에게 필수인 기술 스택은 없다고 생각합니다. 이 질문에는 2018년 글에 달았던 댓글과 지금도 비슷하게 답하고 싶습니다. 그때의 대답을 다듬어서 옮겨 봅니다.
신입 채용에서도 입사 후 바로 쓸 수 있는 실무 기술을 알면 당연히 합격에 도움이 됩니다. 실무자인 면접관과 나눌 수 있는 이야기가 많아지기 때문입니다. 당장 와서 일할 수 있는 사람을 찾는 조직에서는 실무 기술을 가급적 많이 아는 사람을 선호할 수도 있습니다.
그러나 실무 기술을 사용한 경험이 있어도 이를 잘 파악하고 있지 않다면 오히려 부정적인 영향을 미칠 수 있습니다. 예를 들면 Java로 DB와 연동하는 개발을 해 봤다고 했는데 그때 MyBatis를 썼는지 JPA를 썼는지도 모르는 경우입니다. 반면 잠깐 써 봐서 깊이 모르는 기술이라도 구체적인 경험을 체계적으로 설명할 수 있다면 더 긍정적인 요인이 됩니다. MyBatis를 잠시 썼는데 어떤 상황이 어려웠고, 알고 보니 프레임워크 내부의 어떤 특성 때문이었고, 어떻게 해결했는지 같은 구체적인 이야기를 하는 사람이라면, 면접관은 '이 사람은 낯선 기술이라도 어려운 문제를 만나면 깊이 파서 해결하는 사람이구나’라고 느낍니다. 그런 사람이면 MyBatis가 아닌 JPA를 쓰는 프로젝트에라도 바로 적응할 수 있겠다는 확신을 줍니다.
신입을 채용할 때는 현재 할 수 있는 일보다 앞으로의 발전 가능성에 더 중점을 둡니다. 면접관은 단편적인 기술 지식을 물어보는 것에 그치지 않고 사람의 학습 능력과 의지를 파악하고자 합니다.
지원자가 발전 가능성을 표현할 수 있는 방법은 여러 가지입니다. 학교에서 한 팀 프로젝트라도 남다르게 한 면이 있다면 실무 기술을 잘 몰라도 앞으로의 발전 가능성을 충분히 보여 줄 수 있습니다. 예를 들면 실사용자의 사용 패턴을 분석해 개선점을 찾아내고, 그 개선을 잘 뒷받침하는 기술 스택을 골라 적용한 경험이 그렇습니다. 코딩 테스트나 면접 질문에 답할 때 이론과 문제의 핵심을 잘 파악해서 코드나 말로 설명하는 것도 자신을 잘 드러낼 수 있는 방법입니다. 실무에서 쓰는 기술을 일부 아는 것은 그 방법 중의 하나일 뿐, 유일한 방법은 아닙니다.
오래전 어느 인턴 지원자의 면접이 기억납니다. 리눅스 커널에 관심이 많은 학생이었지만 당시 인턴 과제는 그 분야가 아니었습니다. 공식 코딩 테스트가 없던 인턴 전형이라, 면접관의 노트북 컴퓨터를 주고 코딩 문제를 풀게 했습니다. 그 학생은 인턴 과제에서는 쓰지 않을 C++를 선택했고, 채점 시스템의 판정으로는 만점을 받지는 못했습니다. 그렇지만 거의 답에 근접한 방식으로 구현했고, 코드를 유창하게 쓰는 과정이 인상적이었습니다. 하나의 방법이 잘 안 되자 그다음 생각나는 아이디어를 바탕으로 빠르게 코드를 입력했습니다. 저는 그 학생을 다른 과제의 인턴 후보자로 추천했습니다.
결과적으로 그 학생은 인턴을 거쳐서 최종 입사했습니다. 그 신입 사원에게 처음 배정된 업무도 원했던 리눅스 커널과 관련된 분야는 아니었습니다. Java 웹 개발과 AngularJS로 프런트엔드 개발까지 했습니다. 그런데 그 신입 사원은 몇 년이 지나서 리눅스 커널에 기여하고 네이버의 가장 큰 기술 콘퍼런스였던 데뷰에서 대형 컨테이너 클러스터에서의 고가용성 Network Load Balancing이라는 발표를 하기도 했습니다. 이를 그해 데뷰 최고의 발표로 꼽는 분도 있었습니다.
실무 기술보다 문제를 풀어 가는 과정에서 발전 가능성이 드러난 예였습니다. 그리고 지금까지의 특기 분야가 아닌 업무를 신입 시절에 하게 될 수도 있고, 시간이 지난 후에 원하는 분야의 업무를 할 상황이 생기기도 합니다.
이 주제로 들어온 구체적인 다른 질문에도 함께 답합니다.
먼저 '신입이 이 정도는 알아야 한다’고 정해진 기술 스택, 예를 들어 메시지 큐 같은 것이 있는지 궁금해하셨습니다.
카프카(Kafka)나 래빗엠큐(RabbitMQ) 같은 지식이 있어야만 국내 톱 티어 IT 기업에 갈 수 있느냐는 질문도 있었습니다. 많은 면접관은 신입 지원자가 '카프카를 써 봤다’는 사실 자체보다 '왜 그런 기술이 필요한가', '비동기 메시징으로 무엇을 얻고 무엇을 감수하는가’를 이해하고 있는지에 관심이 있습니다. 앞에서 든 JPA와 MyBatis의 예와 동일한 맥락입니다.
신입으로 지원하려는 학생인데 채용 공고에는 거의 시니어급 조건이 걸려 있어 막막하다는 고민을 주신 분도 계셨습니다. 예를 들면 실시간 대규모 트래픽 처리 경험이나 MSA(마이크로서비스 아키텍처) 환경 같은 조건입니다. 그런 공고가 정말로 그 경험이 있어야 한다는 뜻인지, 아니면 그 개념을 잘 아는지를 보려는 것인지 궁금해하셨습니다. 채용 공고를 쓰신 분도 학생이 운영 환경의 대규모 트래픽을 직접 다뤄 봤을 가능성이 낮다는 점은 아실 것입니다. 혹시라도 어떤 회사의 신입 채용 공고에 학생들이 직접 경험하기 어려운 기술이 적혀 있다면, '이런 기술이 다루는 문제를 해결할 의지와 역량이 있는 사람을 찾는다’는 의도일 가능성이 높습니다.
'러스트 스택만 써도 되느냐’는 질문에도 메시지 큐와 같은 맥락으로 답할 수 있습니다. 어떤 언어 하나만 깊이 다뤄 본 경험도 충분히 좋은 무기가 됩니다. 중요한 요소는 그 언어로 어떤 문제를 어떻게 풀어 봤고, 그 과정에서 무엇을 깊이 이해했는가입니다. 하나의 기술 스택을 깊이 파 본 사람이 다른 기술로 옮겨 가는 비용은 문법과 라이브러리 사용법을 AI가 바로 알려 주므로 예전보다 낮아졌습니다.
프로그래밍 언어 전반을 묻는 질문도 있었습니다. 요즘 실무에서 어떤 언어를 많이 쓰는지, 여러 새로운 언어가 등장하는데 Java의 시대도 끝날 것이라고 보는지 물어보셨습니다. 제가 속한 실무 환경에서는 Java와 Kotlin이 여전히 큰 비중을 차지하고, 분야에 따라 Go, Python, JavaScript, TypeScript 등이 함께 쓰입니다. Java의 시대가 끝날 것이냐는 질문에는 '꼭 Java만이 해결책인 분야는 줄어들겠지만, 여전히 적합한 분야는 있다’고 답하고 싶습니다. 이미 쌓인 코드 자산과 생태계가 있기 때문입니다. 한편 최근 메모리 가격이 급등한 만큼, Rust나 Go처럼 메모리를 적게 쓰는 언어가 앞으로 더 많이 쓰일 것으로도 예상합니다.[13] 학생 시기에는 앞의 러스트 질문에 답한 것처럼 하나의 언어를 깊이 파는 것도 괜찮습니다. 다만 실무에 들어간 뒤에는 기술 포트폴리오를 특정 언어에 한정하지 않는 편이 좋습니다. 풀어야 할 문제와 조직의 환경에 따라 여러 언어를 문제 해결의 도구로 선택하고 AI 에이전트로 코드를 관리하는 역량이 앞으로 더 중요해질 것입니다.
공부할 환경은 뒤에 나오는 '취업 전에 어떻게 실무와 가까운 경험을 쌓을 수 있을까요?'에서, 공부할 내용은 '역량과 경력 발전’의 로드맵과 아키텍처 답변에서 이어서 다루겠습니다.
신입 채용을 통과하는 사람은 어떤 공통적인 특징이 있을까요?
앞에서 말씀드린 대로 발전 가능성을 구체적인 경험으로 설명한 지원자가 채용 전형을 통과할 확률이 높습니다. 그 경험이 꼭 크고 대단한 프로젝트일 필요는 없고, 어려운 문제를 만났을 때 끝까지 물고 늘어진 이야기가 더 큰 신뢰를 줍니다.
컴퓨터 과학이나 공학 전공자에게 가산점이 있느냐는 질문도 있었습니다. 전공을 했다는 단순한 사실보다는 전공을 통해 얻은 역량이 있는지가 중요합니다. 컴퓨터 과학 비전공자라도 일을 하는 데 필요한 역량을 쌓은 과정이 있다면 마찬가지로 인정받을 수 있습니다.
학생 개발자가 AI를 사용하는 것이 취업에 부정적으로 영향을 미치지는 않나요?
채용 전형 과정 중 AI 활용은 과제별 안내에 따라야 합니다. 평소 코딩을 할 때 AI를 사용한다는 사실 자체가 취업에 부정적으로 작용하지는 않습니다. AI 활용은 이제 개발자의 기본 소양입니다. 그러니 지원서에 적힌 프로젝트에서 'AI를 썼다’는 사실을 숨길 필요는 없습니다.
다만 AI가 만들어 준 결과물을 본인이 이해하고 있는지, 그것을 비평할 수 있는지는 실무에서도 중요하기에 면접관도 중요하게 볼 가능성이 높습니다. AI가 생성한 코드를 그대로 배포해서 버그가 생겼음에도 그 원인을 이해할 수 없다면 AI를 잘 활용한다고 말하기는 어렵습니다. 반대로 'AI에게 이런 방식으로 일을 시켰고, 결과물에서 이런 부분이 미심쩍어 이렇게 검증하고 고쳤다’는 설명할 수 있다면, 그것은 현시점에 필요한 역량을 갖췄다는 긍정적인 신호입니다.
취업 전에 어떻게 실무와 가까운 경험을 쌓을 수 있을까요?
학교에 백엔드 수업이 없어서 혼자 공부를 시작하려는데 어떻게 해야 할지, 부트캠프를 가는 것이 좋을지 물어보셨습니다. 공부 방법에 하나의 정답은 없지만, '피드백을 줄 수 있는 동료’는 큰 도움이 됩니다. 혼자 공부하면 자신이 무엇을 잘못 알고 있는지조차 알기 어렵습니다. AI에게 피드백을 받을 수 있는 폭이 넓어진 지금도, 사람 동료가 주는 피드백의 가치는 여전히 큽니다. 같은 코드를 두고 다른 관점을 듣고, 내 설명이 상대에게 잘 전달되는지를 확인하는 경험은 혼자서는 얻기 어렵습니다. 부트캠프를 고민하신다면 커리큘럼의 화려함보다 '함께 배우고 서로 피드백을 주고받을 동료와 멘토가 있는가’를 기준으로 보시길 권합니다. 스터디 그룹, 오픈소스 기여, 작은 사이드 프로젝트를 여럿이 함께 하는 것도 좋은 방법입니다.
함께 배우는 동료는 앞에서 말씀드린 학습의 불편함을 버티는 힘도 됩니다. 사회가 밤에 야식으로 치킨을 먹는 사람보다 달리기를 하러 나가는 사람을 예찬하듯이, 불편함을 감수하는 학습 활동을 격려하는 문화도 필요합니다. 그런 노력이 가치 있다는 믿음을 지지해 주는 학습 공동체를 찾거나 직접 만들어 보시기 바랍니다.
백엔드와 프런트엔드가 실제로 어떻게 협업하는지, 애자일 같은 워크플로가 현장에서 정말 어떻게 돌아가는지도 궁금해하셨습니다. '현장의 애자일’은 팀마다 상당히 다릅니다. 정해진 하나의 방식이 있다기보다, 각 팀이 자신의 상황에 맞게 변형한 방식으로 일합니다. 다만 공통점은 있습니다. 큰 목표를 작은 단위로 쪼개고, 짧은 주기로 만들어 보고, 피드백을 받아 다음 주기에 반영하는 흐름입니다. 이 흐름은 역할 답변에서 말씀드린, AI 에이전트에게 일을 나눠 맡기고 결과에 빠르게 피드백을 주는 사이클과도 본질적으로 같습니다. 그래서 작은 프로젝트라도 직접 이 사이클을 반복해 보는 경험은 좋은 연습이 됩니다.
[역량과 경력 발전]
함께 일하고 싶은 개발자는 어떤 개발자인가요?
첫째는 일을 투명하게 진행하는 개발자입니다. 지금 어디까지 진행했고 어디서 막혔는지를 공유하며, 필요할 때 빠르게 도움을 청하고, 자신의 판단 근거를 다른 사람이 이해할 수 있게 설명하는 사람입니다. 진행 상황과 판단 근거를 글로 남기면 그 기록이 그대로 AI 에이전트의 컨텍스트가 되므로, 이런 투명성의 부가가치는 근래에 더 커졌습니다.
둘째는 일이 진행되다가 생긴 빈자리를 메워 주는 개발자입니다. 앞서 개발팀은 야구팀보다 축구팀이나 농구팀에 가깝다고 말씀드렸습니다. 소프트웨어가 완성되기 위해서는 자신이 익숙한 전문 영역에만 머물지 않고 공백이 생긴 다른 영역에 기꺼이 기여하는 사람이 필요할 때가 많습니다.
셋째는 앞서 말씀드린 지적 겸손을 갖춘 개발자입니다. 자신의 판단이 틀릴 수 있다는 가능성을 늘 열어 두는 사람, 동료의 피드백을 방어가 아니라 성장의 기회로 받아들이고 계속 배우려는 사람과 함께 일할 때 팀 전체가 성장합니다.
주니어와 시니어 등 연차별로 어떤 역량을 발전시켜 나가야 할까요?
연차별로 발전시켜야 할 역량은 '내가 책임지는 범위를 점점 넓혀 가는 힘’이라고 생각합니다. 그리고 그 범위가 넓어질수록 길어지는 과정을 버텨 낼 정신적 에너지도 함께 쌓아 가야 합니다.
본인이 책임지는 결과를 완성하는 기간이 경력이 늘어날수록 더 길어지는 경향이 있습니다. 신입에게는 본인에게 맡겨진 기능 하나를 개발하는 것이 책임의 완수라면 개발 리더에게는 전체 프로젝트, 더 나아가서는 회사의 사업 성과가 개선되는 것까지도 책임의 영역입니다. 모든 개발자가 AI 팀의 관리자가 되었다는 말은, 책임 범위가 넓어지는 속도도 과거보다 빨라졌다는 뜻이기도 합니다. 신입이 AI 에이전트에게 맡긴 작업의 결과까지 책임지는 순간은 이전 세대보다 일찍 찾아옵니다. 저는 앞으로의 개발자를 양성하는 과정은 '관리자를 빠르게 키워 내는 사관학교’와 가까워지지 않을까 하는 상상도 해 봅니다.
경력이 많으신 분들이 어려운 일을 헤쳐 나갈 수 있는 에너지의 원천은 직장 생활 초창기부터 쌓여 온 '작은 성취감’들이라고 생각합니다. 신입 때부터 짧은 주기로 성취감을 느끼는 환경과 장치들을 고안해 보셨으면 합니다. 짧은 주기로 업무의 완료 수준과 시기를 스스로 먼저 선언하고 지키는 일이나, 하루하루 작은 지식을 기록하고 공유하는 일도 성취감을 자주 느끼는 습관을 만드는 데 도움이 됩니다.
경력이 쌓이면 강점과 약점도 달라집니다. 인간의 자연스러운 노화를 고려하면 시니어급은 1년 차보다 단기 학습 능력이나 집중력이 떨어질 수 있습니다. 대신 쌓인 경험을 바탕으로 여러 측면을 고려해 결정하고, 같은 상황이라면 스트레스를 덜 받고, 유연하게 대처할 수 있을 가능성은 높아집니다. 전자의 약점을 후자의 강점으로 메워야겠다고 저도 생각합니다.
어떤 로드맵으로 공부해야 할까요?
언어와 프레임워크까지는 공부했는데 그다음 무엇을 어떤 순서로 공부해야 할지 감이 잡히지 않는다는 질문을 많이 주셨습니다. 정해진 로드맵을 기대하셨을 수도 있지만, '누구에게나 통하는 표준 로드맵’으로는 앞에서 말씀드린 목적성이 있는 지식을 정밀하게 채우기 어렵다고 생각합니다. 진로 답변에서 이야기한 '자신만의 주제’에 맞추어 '나는 어떤 문제를 풀고 싶은가’를 먼저 정하시기 바랍니다.
풀고 싶은 문제가 정해지면 무엇을 공부할지가 구체적으로 보입니다. 예를 들어 대용량 데이터 처리 아키텍처에 끌린다면, 그 주제 하나를 정해 관련된 실무 사례들을 많이 찾아보고 참고하면서 학습 경로를 그릴 수 있습니다. 실무 사례는 발표 자료, 기술 블로그, 오픈소스 코드 등 곳곳에 풍부하게 공개되어 있습니다. 하나의 주제를 깊이 파고들다 보면 그 과정 자체가 '나만의 로드맵’이 됩니다.
좋은 포트폴리오가 공통적으로 만족하는 조건이 무엇이냐는 질문도 같은 맥락에서 답할 수 있습니다. 많은 기술 스택의 나열보다, '본인만의 스토리가 있는가’가 중요합니다. 왜 이 문제에 관심을 두었고, 어떤 가설을 세웠고, 무엇이 어려웠고, 어떻게 해결했고, 무엇을 배웠는지가 하나의 이야기로 이어지는 포트폴리오가 사람을 설득합니다.
'어떤 부분을 공부해야 희귀하고 실력을 인정받는 백엔드 개발자가 될 수 있는가’라는 질문에도 비슷하게 답하고 싶습니다. 희소성은 특정 기술 하나를 안다는 데서 나오기 어렵습니다. 앞서 여러 관점의 기준을 조합하는 역량을 말씀드렸듯이, 희소함도 단순히 특이한 조합보다는 남들이 잘 발견하지 못한 부가가치가 있는 조합에서 나옵니다. 예를 들면 교양 과목에서 접한 지식과 개발 기술의 조합이 그렇습니다. 그 조합을 하나로 꿰어 주는 것도 포트폴리오처럼 결국 본인만의 이야기입니다.
아키텍처 설계를 어떻게 공부하면 좋을까요?
아키텍처 설계, 특히 대규모 트래픽 처리 같은 주제는 직접 운영 환경에서 경험해 보는 것이 가장 좋습니다. 하지만 학생 신분에서 그런 환경을 직접 만나기는 어렵습니다. 그렇다면 작은 시스템에서부터 아키텍처를 도출하고 발전시키는 연습을 해 보시길 권합니다.
먼저 '작은 시스템에서 아키텍처라고 할 만한 요소는 무엇일까’를 생각해 보면 좋습니다. 혼자 만든 작은 웹 서비스에도 데이터를 어디에 저장할지, 요청을 어떻게 처리할지, 외부 시스템과 어떻게 연동할지 같은 구조적 결정이 있습니다. 그 결정 하나하나가 아키텍처입니다. '왜 이렇게 구성했는가’를 스스로 설명할 수 있다면 그것이 아키텍처 공부의 시작입니다.
그다음에는 점진적으로 시스템의 다음 단계를 상상해 보는 연습이 효과적입니다. 예를 들어 '지금은 서버가 한 대인데, 이 서버가 죽으면 서비스 전체가 멈춘다. 이 단일 장애점(Single Point of Failure)을 갑자기 없애야 한다면 무엇을 어떻게 바꿔야 할까?'라고 스스로 질문을 던져 보는 것입니다. '사용자가 지금의 백 배로 늘어난다면', '데이터가 한 대의 DB에 담기지 않는다면' 같은 가정을 하나씩 얹어 가며 구조가 어떻게 진화해야 할지를 머릿속으로, 또 작은 실험으로 그려 보시기 바랍니다. 그러면 실무에서 마주치는 아키텍처 고민의 본질에 꽤 가까이 다가갈 수 있습니다.
이런 가정에 들어갈 트래픽 규모를 실무에서는 어떻게 정하는지도 물어보셨습니다. 보통은 비즈니스 목표에서 출발합니다. 예상 사용자 수, 사용 패턴, 피크 시간대 같은 가정을 세우고 거기에 여유분을 더해 목표 수치를 잡습니다. 처음부터 정확할 수는 없기 때문에, 실제 트래픽을 측정하면서 가정을 계속 수정해 나갑니다.
실무자들도 모든 경우를 다 경험해 보고 설계하는 것은 아닙니다. 오히려 필요 이상으로 복잡하게 만드는 오버엔지니어링도 현장에서 흔하게 일어납니다. 그러니 '완벽한 설계를 미리 알아야 한다’는 부담을 내려놓으셔도 됩니다. 지금 필요한 만큼만 단순하게 설계하고, 필요가 생겼을 때 다음 단계를 그려 가며 발전시켜 나가는 태도 자체가 좋은 아키텍트의 자질입니다.
개발자를 꿈꾸는 학생들에게 추천하고 싶은 책이 있나요?
우선 기술 분야는 좋은 책이 계속 새로 나오고 스스로 정한 학습 로드맵에 따라서 적합한 책이 다를 것 같습니다. 그래서 특정 책 목록을 정해서 드리기보다 관심을 두면 좋을 책의 특징을 두 종류로 말씀드립니다.
첫째는 소프트웨어 개발의 큰 그림을 다루는 책입니다. 요구사항을 정의하고 구조를 설계하고 여러 사람이 협업하여 시스템을 만들고 오랜 시간에 걸쳐 운영하는 개발의 전 과정이 담겨 있는 책들을 추천합니다. '아키텍처', '아키텍트', '소프트웨어 엔지니어링' 같은 키워드가 들어간 책들이 여기에 해당합니다. AI 시대에는 이런 지식의 가치가 더 커지고 있습니다.
둘째는 현장 개발자의 경험담을 담은 책입니다. 한 사람이 오랜 시간 현장에서 부딪치며 얻은 통찰과 시행착오를 담은 책은 정제된 이론서가 주지 못하는 생생한 맥락을 전해 줍니다. 어떤 결정을 왜 내렸는지, 무엇을 후회하는지 같은 이야기는 정답이 없는 문제 앞에서 스스로 판단하는 법을 배우는 데 큰 도움이 됩니다. 그런 책들을 여러 권 읽는다면 한 사람의 편향에 기울어지지 않은 기술적 취향을 만들 수 있습니다.
기술 외의 분야까지 넓히면 추천드리고 싶은 책이 더 많습니다. 그중 이 글을 쓰는 데 영향을 주었던 두 권의 책을 추천합니다.
살면서 한번은 벽돌책 표지 (이미지 출처: 글항아리)
한 권은 장강명의 살면서 한번은 벽돌책 (글항아리, 2026)입니다. 앞에서 말씀드린 '지적 지구력’이라는 표현은 이 책에서 가져왔습니다. 저자는 두꺼운 책을 끝까지 읽어 내는 힘을 '정신의 기초 체력’이라고 부르며, 그 힘이 없는 사람을 150쪽에서 이렇게 묘사합니다.
지적 지구력이 떨어지는 사람은 복잡한 사유를 견디지 못합니다. 모호한 문제, 불확실한 문제 앞에서 그는 얼른 단순한 설명을 찾으려고 하죠. 그러다보니 성급하게 감정적으로 판단을 내리거나 다른 사람의 결론을 그대로 따릅니다.
충돌하는 기준을 조합해 균형 잡힌 결정을 내리는 개발자의 일은 복잡한 사유를 견뎌야 하는 일입니다. AI가 그럴듯한 결론을 바로 내놓는 지금은 '다른 사람의 결론’을 'AI의 결론’으로 바꿔 읽어도 됩니다. 수백 쪽에 걸친 논증을 꾹 참고 따라가는 독서는 그 지구력을 기르는 훈련입니다.
지능 파산 표지 (이미지 출처: 바다출판사)
다른 한 권은 한소원의 지능 파산 (바다출판사, 2026)입니다. AI에 기댈수록 생각하는 능력과 사람을 대하는 능력이 어떻게 약해지는지를 심리학과 뇌과학 연구로 설명한 책으로, 앞에서 사회적 능력의 퇴화와 학습 과정을 말씀드릴 때 참고했습니다. 저자가 231~232쪽에서 내린 AI 리터러시의 정의가 특히 기억에 남습니다.
내가 스스로 생각하는 것이 가치 있다는 것을 아는 것, 그게 바로 AI 리터러시다.
AI 활용은 개발자의 기본 소양이라고 앞에서 말씀드렸습니다. 그 소양에는 도구를 다루는 기술만이 아니라, 어떤 생각을 AI에게 맡기고 어떤 생각은 스스로 할지 고르는 판단이 들어 있어야 합니다. AI를 더 잘 쓰기 위해서라도 생각을 직접 정리해 보는 시간을 가져 보는 것이 좋습니다.
마치며
이 글을 쓰면서 전편을 썼던 2018년 이후에 제가 어떤 경험을 했는지를 돌아봤습니다. 그 사이에 저는 연간 수십조 원의 거래액을 처리하는 시스템의 아키텍처 개편 프로젝트에 참여했습니다. 그 프로젝트의 경험을 요약하면 '운영 환경의 중압감’이었습니다. 앞에서 말씀드린 개발 환경과 운영 환경의 차이는 제가 여러 번의 장애로 몸소 겪은 것이기도 합니다. 어떤 사고는 뉴스에 나오기도 했고, 고객 센터 상담원을 비롯한 동료와 사용자분들에게 고통을 끼쳤습니다. 큰 문제가 생길 때마다 과거로 돌아간다면 무엇을 바꿨을까, 내가 더 할 수 있었던 일은 없었을까 하는 생각을 되풀이하며 밤잠을 설치기도 했습니다.
Java의 창시자인 제임스 고슬링(James Gosling)은 2003년에 소프트웨어의 실패(failure)를 주제로 인터뷰에 응했습니다. 그는 항공기에 들어가는 소프트웨어를 개발하는 회사의 정책을 다음과 같이 언급했습니다.
시험 비행 조종사가 추락해 사망하면, 무슨 일이 있었는지 모두 밝혀진 뒤에 실패한 부분을 설계한 엔지니어들이 유가족을 찾아가 설명하도록 하는 정책이 있는 곳이 여러 군데 있습니다. 실제로 그런 일을 해야만 했던 사람은 딱 한 명 만나 보았습니다. 그런 일을 겪고 나면 실패를 대하는 태도가 금세 달라질 것입니다.
There are a number of places that have policies that if a test pilot augers in, then once it’s all figured out what happened, the people who engineered the thing that failed have to go explain it to the family. I’ve actually only met one person who has ever actually had to do that. That would change your attitude about dealing with failure really quickly.
출처: Failure and Exceptions: A Conversation with James Gosling
위와 같이 어떤 버그는 돌이킬 수 없는 사고를 만듭니다. 1991년 걸프전에서는 패트리어트 미사일 시스템의 오류로 요격에 실패해 미군 28명이 목숨을 잃었습니다. 사람의 목숨이 걸린 시스템을 만드는 개발자는 극히 일부라고 생각할 수도 있습니다. 그러나 목숨까지는 아니더라도 누군가의 인생에 큰 영향을 주는 시스템을 만드는 개발자는 소수가 아닙니다. 예를 들면 2011년 교육행정정보시스템(NEIS)의 버그는 고등학생 2만 9천여 명의 내신 석차를 뒤바꿔 놓았습니다. 그리고 모든 개발자는 적어도 많은 사람의 평온한 일상에 영향을 미치는 시스템을 만들고 있습니다. 앞에서 말씀드린 고객 센터 상담원분들의 일상이 그렇습니다. 자신은 아무 잘못도 하지 않았는데 분노한 사용자들의 전화를 받아야 합니다.
이런 사례를 말씀드린 이유는 'AI 시대에도 구현 기술을 상세하게 공부해야 하는가’라는 질문을 한 번 더 생각해 보기 위해서입니다. 최신 LLM의 성능이 계속 좋아지면서 깊은 지식 없이도 해낼 수 있는 개발이 민감한 분야까지 넓어질 것입니다. 앞으로는 내 컴퓨터에서 실행할 수 있는 모델도 거의 완벽한 코드를 만들어 줄 가능성이 높습니다. 앞에서 말씀드린 과거의 C나 어셈블리어에 대한 예찬과 같이 현재의 구현 지식은 지나간 시대의 토템으로 여기는 사람이 더 많아질 것입니다. 구체적인 기술을 배우는 노력이 경제적 이득으로 연결되는 가성비도 점점 떨어질지도 모릅니다. 'AI 시대의 개발자는 코딩을 몰라도 된다’는 주장이 왜 나오는지는 이해합니다. 그럼에도 구현 기술 공부가 재미있다고 느끼신다면 굳이 가성비를 따질 필요는 없습니다. 인기 드라마 시리즈보다 더 나은 여가 선용입니다.
무엇보다 LLM이 99.99%의 확률로 문제없는 코드를 만들더라도 남은 0.01%의 위험은 사라지지 않습니다. 개발자가 머릿속에 담고 있는 지식이 미래에 여러 사람이 불행해질 사고가 일어날 확률을 조금이라도 낮출 수 있다면, 저는 그것만으로도 의미가 있다고 생각합니다. 앞에서 언급한 패트리어트 미사일과 NEIS 시스템의 버그는 모두 0.1 같은 소수를 2진수로 표현하면서 생긴 오차를 보정하지 못해 일어났습니다.[14] 이 표현 방식도 앞에서 말씀드린 '실행되는 프로그램 작성에 필수가 아닌 지식’에 속합니다. 그럼에도 중요한 코드를 승인하는 사람은 그 한계를 알아야 합니다. 모른다면 AI에게 '이 금액 계산에 부동소수점 오차가 문제를 일으킬 여지는 없는가’라고 물어볼 수조차 없습니다. AI가 사람의 불완전한 지시나 기존의 잘못된 코드를 따라 버그를 만들었다면, 그 코드의 위험성을 이해하지 못한 채 승인한 개발자가 불행의 당사자 앞에서 '사람으로서 할 수 있는 최선을 다했다’고 말하기는 어려울 것입니다. 미안함과 자책, 후회는 AI가 아닌 사람의 마음속에 남습니다.
AI 시대의 개발자에게는 많은 일을 빠르게 해내는 초능력이 주어졌습니다. 큰 힘에는 큰 책임이 따릅니다. 사회의 기반 시설과 일상이 소프트웨어에 의존하는 만큼 개발자에게 맡겨진 책임도 더 커졌습니다. 보상이나 권리보다 개발자가 짊어진 압박감과 부담감이 너무 커서 불공평하다고 생각하는 분도 있으실 듯합니다. 대신 AI로 얻은 큰 힘을 책임감 있게 다루는 사람에게는 다른 사람들의 신뢰라는 또 다른 힘이 주어집니다. 이 신뢰는 앞에서 말씀드린 AI의 권위와 다릅니다. 사람들은 AI에게 좋은 답을 기대하지만, 답이 틀렸을 때 그 결과를 함께 감당하고 끝까지 수습해 주리라 믿는 대상은 사람입니다. 책임을 다하지 못했을 때 잃는 것이 있기에 사람은 절실하게 노력한다는 것을 알기 때문입니다. AI가 '확률적 연결’로 사람의 기능적 능력을 압도하는 시대에도, '신뢰’와 같이 사람 사이에 쌓이는 '정서적 연결’만큼은 AI가 대신할 수 없습니다. 그러한 연결을 쌓은 사람은 더 중요하고 큰 의사결정을 할 수 있는 권한을 얻고, 그가 제시하는 목표는 여러 사람이 함께 꾸는 꿈이 됩니다.
책임감으로 불행을 막고 신뢰로 공동의 꿈을 이루어 갈 개발자, 내일의 영웅들을 기다립니다.
1 빌 게이츠는 2023년 3월 21일 글 'The Age of AI has begun'에서 AI의 발전이 마이크로프로세서, PC, 인터넷, 휴대전화의 등장만큼 근본적인 변화라고 썼습니다. 순다르 피차이는 2018년 1월 대담에서 AI가 전기나 불보다 더 심대한(more profound) 영향을 줄 것이라고 말했습니다. CNBC 보도
2 Addy Osmani, Morgan Westlee Lunt, Qing Wang, "How the Claude Code team does code review", Anthropic, 2026년 10월 15일. 목표는 대부분의 풀 리퀘스트가 많아야 사람 한 명(작성자 본인일 수도 있음)만 거쳐 병합되되 되돌림(revert)과 장애가 늘지 않는 것이라고 밝혔습니다.
3 한소원, 지능 파산: AI 시대, 편리함에 갇혀 버린 사람들 (바다출판사, 2026), 8쪽, 27쪽, 56~57쪽, 79쪽. 이 책은 AI의 '당신이 옳다’는 반응에 익숙해져 불편함을 피하려고 사람과의 소통을 피하게 되는 현상을 '사회적 기술의 퇴화(social deskilling)'로 소개하고, 사회적 갈등을 AI와 상의한 사용자가 자신이 틀렸을 때도 옳다고 믿고 다른 사람과 갈등을 해결하려는 의지가 줄었다는 연구 결과를 인용합니다.
4 사람의 뇌가 약 20W로 동작한다는 추정은 다음 글을 참고했습니다. Vijay Balasubramanian, "Brain power", PNAS 118(32), e2107022118 (2021). DOI
5 문광주, "AI가 우리의 자아상을 어떻게 변화시키는가", the SCIENCE plus, 2025년 10월 30일. 핀란드 알토 대학교(Aalto University) 연구진은 참가자 약 500명에게 미국 로스쿨 입학시험(LSAT)의 논리 문제 20개를 풀게 하고 절반에게만 ChatGPT를 쓰게 했습니다. AI를 쓴 집단은 점수가 대조군보다 3점 높았지만 자신의 성과를 4점 과대평가했고, AI 리터러시 설문에서 자신을 높게 평가한 사람일수록 과신이 심했습니다. 연구진은 현재의 AI 도구가 메타 인지를 길러 주지 못하고 사용자가 실수에서 배우게 하지도 못한다며, AI가 사용자에게 추론을 설명해 보라고 묻는 식으로 성찰을 유도하는 설계가 필요하다고 말했습니다. 같은 기사는 AI 요약으로 학습한 사람이 구글 검색으로 학습한 사람보다 더 짧고 정보가 부족하며 독창성이 떨어지는 글을 썼다는 펜실베이니아 대학교의 연구도 소개합니다.
6 한소원, 지능 파산, 203~204쪽, 207쪽, 233쪽. 검색해서 답을 찾는 것은 정보를 빌려 오는 것에 불과하고, 진정한 학습은 기존의 지식 체계와 연결해 고유한 맥락을 만들어 내는 생성적 과정이며 배운 내용을 자신만의 언어로 다시 설명하거나 요약할 때 완성된다고 설명합니다. 생성형 AI가 그 '생성’의 과정을 대체하면 학습의 본질까지 대체한다고 경고하고, 인지 부하를 의도적으로 높여 지식을 장기 기억으로 바꾸는 '바람직한 어려움’을 학습의 핵심 원리로 듭니다.
7 영어 위키백과의 'T-shaped skills' 항목은 1980년대 맥킨지(McKinsey & Company)가 컨설턴트 채용과 육성에 'T-shaped man’이라는 말을 내부적으로 썼다고 소개하고, 이 용어가 대중적으로 쓰인 이른 사례로 1991년 9월 17일 The Independent 기사 'The hunt is on for the Renaissance Man of computing’을 듭니다. T-shaped skills
8 일론 머스크는 2026년 2월 xAI 전체 회의에서 '이르면 올해 말쯤에는 코딩을 아예 하지 않아도 되는 쪽으로 갈 것', 'AI가 바이너리를 바로 만든다’고 말했습니다. Reuters 보도(Malay Mail 전재)
9 미국 연방 제1순회 항소법원, "O’Connor v. Oakhurst Dairy", 2017년 3월 13일. 판결문은 'For want of a comma, we have this case.'(쉼표 하나가 없어서 이 사건이 생겼다)로 시작합니다. Bloomberg Law 보도
10 Edsger W. Dijkstra, "On the foolishness of 'natural language programming'", EWD667. 원문은 'The virtue of formal texts is that their manipulations, in order to be legitimate, need to satisfy only a few simple rules; they are, when you come to think of it, an amazingly effective tool for ruling out all sorts of nonsense that, when we use our native tongues, are almost impossible to avoid.'입니다.
11 Gergely Orosz, "When AI writes almost all code, what happens to software engineering?", The Pragmatic Engineer, 2026년 1월 6일. 스스로 할 일을 찾아 만드는 '프로덕트 엔지니어’를 채용하는 스타트업 사례(WorkOS, Linear)를 소개하고, 스타트업이 프런트엔드와 백엔드 개발자를 따로 뽑는 미래는 예상하기 어렵다고 전망합니다.
12 Capers Jones, Applied Software Measurement: Global Analysis of Productivity and Quality, 3rd ed. (New York: McGraw-Hill, 2008). 존스의 2017년 보고서 "Software Economics and Function Point Metrics: Thirty Years of IFPUG Progress"(Namcook Analytics) 표 16에 실린 함수 포인트당 소스 코드 줄 수에 따르면 기본 어셈블리는 약 320줄, C는 128줄, Java는 약 53줄, C#은 약 51줄이 필요하여, 어셈블리 대비 현대 객체지향 언어는 같은 기능을 약 6배 적은 코드로 구현합니다. 다만 존스는 언어가 다르면 코드 줄 수로 생산성을 비교해서는 안 된다고 주장합니다. 요구사항 정리, 설계, 문서화는 코드량이 줄어도 그대로 드는 고정비용이라서, 코드가 줄어든 비율만큼 전체 공수가 줄지는 않기 때문입니다. 같은 보고서 표 1에 실린 IBM 컴파일러 사례의 어림 수치에서는 어셈블리 17,500줄이 PL/S 5,000줄로 3.5배 줄었지만, 공수는 30인월에서 12.5인월로 2.4배 줄었습니다.
13 TrendForce는 분기별 전망 발표에서 범용 DRAM 계약 가격이 전 분기 대비 2026년 1분기 90~95%, 2분기 58~63%, 4분기 10~15% 오를 것으로 예측했습니다. TrendForce 발표(1분기), TrendForce 발표(2분기), TrendForce 발표(4분기)
14 패트리어트 시스템은 24비트 고정소수점으로 표현한 0.1의 버림 오차가 약 100시간 가동 동안 0.34초로 쌓여 레이더가 미사일을 놓쳤습니다. NEIS는 부동소수점 반올림 오차 때문에 총점이 같은 학생이 동점자로 판별되지 않아 석차가 뒤바뀌었습니다. 두 사고의 더 자세한 원인은 'IEEE 754 부동소수점 오차와 Java의 대안'을 참고하실 수 있습니다.