요약
Python의 멀티프로세싱과 Airflow의 task 동작 방식 - Python과 Airflow, 그리고 관련된 문제 해결기 1편에서는 Airflow가 task를 실행할 때 요구되는 병렬성과 격리성을 살펴보고, 이를 만족하기 위해 Airflow가 task마다 만들었다 버리는 단기 프로세스와 만들어 두고 재사용하는 장기 프로세스를 모두 fork 방식으로 생성한다는 점을 확인했습니다. fork는 생성 속도와 메모리 효율 모두에서 spawn을 크게 앞섰지만, 두 가지 한계가 따라온다는 점도 언급했습니다. 부모의 자원을 그대로 승계한다는 점과, Python에서는 Copy-on-Write(COW)가 기대만큼 동작하지 않는다는 점입니다.
이번 글에서는 이 두 한계가 저희 PoC(Proof of Concept) 환경에서 실제로 어떤 문제로 나타났는지부터 시작합니다. 두 문제는 worker 프로세스의 메모리가 계속 늘어나는 현상과, MySQL 환경에서 dag-processor가 간헐적으로 재시작되는 현상이었습니다. 겉으로는 전혀 다른 두 증상이었지만, 파고들면 결국 Python의 GC가 fork와 만나면서 생기는 문제라는 공통점이 있습니다. 원인을 추적해 해결하고 Airflow에 기여하기까지의 과정을 자세히 다룹니다.
PoC 과정에서 발견한 두 가지 문제
문제 1: worker 프로세스의 메모리가 계속 증가한다
Airflow 3.1 계열을 CeleryExecutor로 PoC하면서 처음 눈에 띈 것은 worker 컨테이너의 메모리 사용량이 시간이 지날수록 늘어나는 현상이었습니다.
CeleryExecutor는 worker 컨테이너 안에 fork로 만든 worker 프로세스를 여러 개 두고 workload를 처리합니다. 1편의 "Airflow의 task 수행 모델"에서 본 것처럼 Airflow 3의 LocalExecutor도 scheduler 프로세스 안에서 worker 프로세스를 fork로 만들어 재사용하는 같은 구조입니다. Airflow 메이저 버전업 초기라 메모리 증가 리포트도 많이 올라와 있어 LocalExecutor부터 조사했습니다.
Memray로 찾은 두 가지 문제
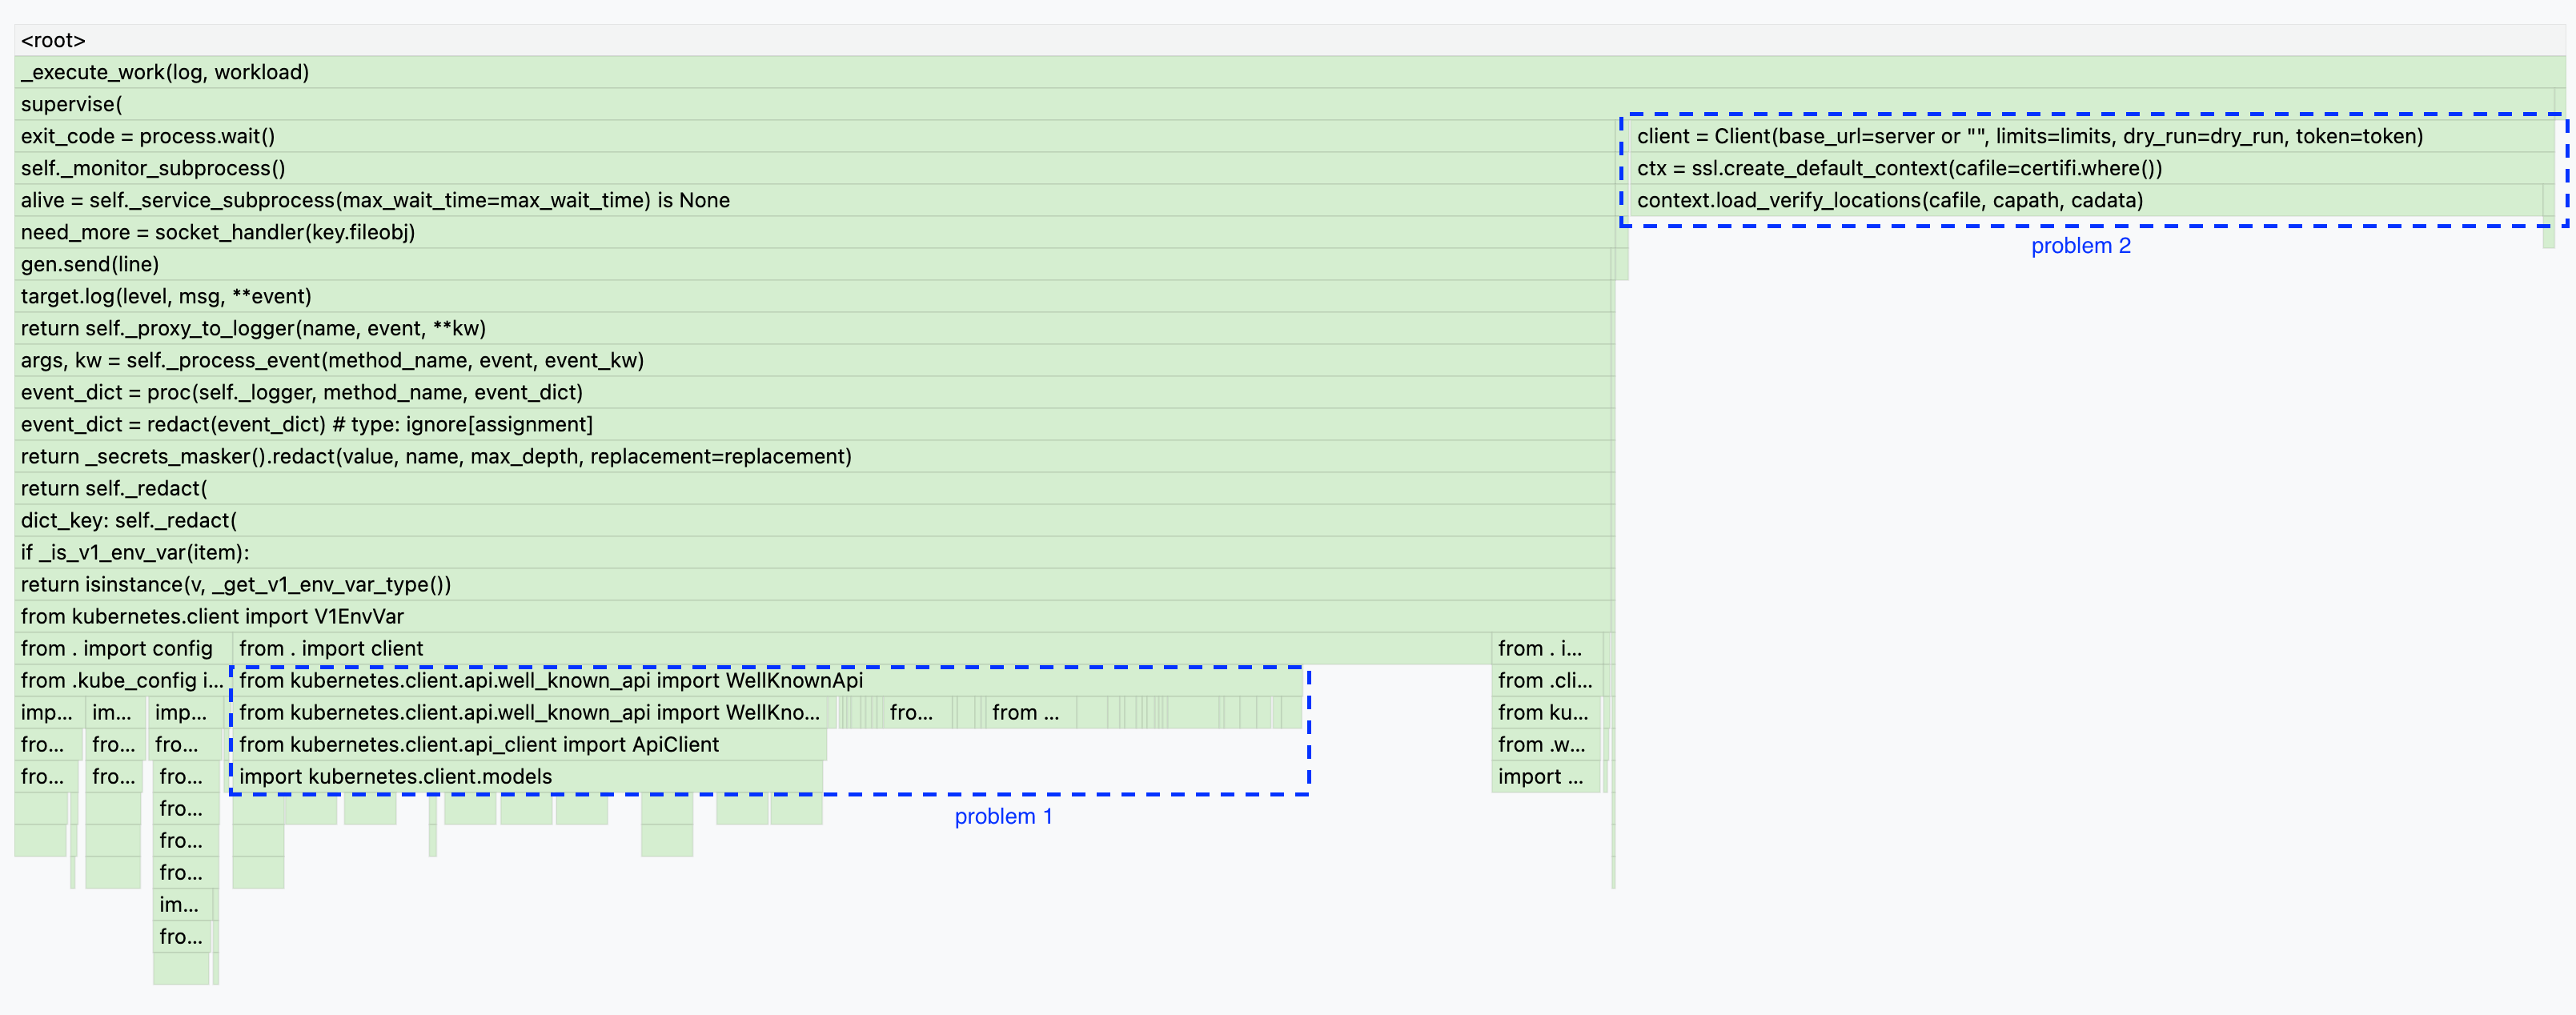
Python 프로세스의 메모리 증가를 볼 때 자주 사용하는 도구는 Memray입니다. 힙(heap) 할당을 호출 스택 단위로 추적하여 UI로 보여 주기 때문에 어느 코드가 메모리를 잡고 있는지 쉽게 확인할 수 있습니다. worker 프로세스 하나를 Memray로 추적한 결과 두 가지 문제를 확인했습니다.
첫째, secrets masker가 타입 확인을 위해 kubernetes.client 전체를 import하고 있었습니다. worker가 task를 실행하는 데 필요 없는 모듈인데, worker당 약 32MB, worker 32개면 1GB 가까이 차지했습니다.
둘째, Task SDK client가 SSL context를 반복 생성하는 누수가 있었습니다. 첫째 문제를 걷어낸 뒤에도 worker 하나가 30분 만에 8MB에서 23MB로 늘었고, 이후로도 멈추지 않았습니다.
두 문제는 전형적인 힙 낭비와 누수였고, Airflow에 이슈로 정리해 올린 뒤 3.1.2에서 해결되었습니다.
이 과정에서 Memray가 매우 유용했기 때문에, 코드 수정 없이 주요 컴포넌트를 Memray 추적 아래 실행할 수 있는 기능과 Memory Profiling with Memray 문서를 Airflow에 추가했습니다.
Memray에 보이지 않는 증가
두 문제를 고친 뒤에도 worker의 메모리 사용량은 여전히 올랐습니다. 문제는 이 증가가 Memray에 잡히지 않았다는 점입니다. 즉, worker 자체가 새로 할당한 메모리는 별로 없는데 메모리 사용량은 늘어나고 있었습니다.
그래서 1편에서 정리한 지표로 돌아갔습니다. 각 프로세스의 PSS, USS를 smem으로 확인했더니 특이한 점이 보였습니다. 생성 직후 20~30MB 수준이던 PSS가 서서히 오르다가, 어느 순간 100MB 이상으로 올라가 내려오지 않습니다. 1~2시간 정도면 대부분의 worker가 이 상태에 도달했습니다.
  PID  Command                          USS(before)  USS(after)  PSS(before)  PSS(after)  RSS(before)  RSS(after)
    7  /usr/python/bin/python3.12            106716      287896       116419      297592       196144      375492
   38  airflow worker -- LocalExec            23280       98988        35810      102606       162572      169284
   39  airflow worker -- LocalExec            23640       98724        36138      102342       162640      169024
   50  airflow worker -- LocalExec            23844       99820        36625      103441       163992      170120
   53  airflow worker -- LocalExec            23756       99840        36545      103460       163928      170136
worker의 RSS는 거의 변하지 않는데 PSS와 USS만 오른다면, 프로세스가 건드리는 페이지의 총량은 그대로인 채 그중 부모와 공유하던 페이지가 자기만의 복사본으로 바뀌고 있다는 뜻입니다. pmap 명령으로 주소 영역별 PSS를 비교해 보면, 부모와 같은 주소를 가진 매핑에서 PSS가 늘어나는 것이 확인되었습니다. 자식 프로세스에서 어떤 쓰기가 일어나 COW가 발생한 것으로 추측할 수 있습니다.
문제 2: MySQL 환경에서 dag-processor가 간헐적으로 재시작된다
두 번째 증상은 전혀 다른 컴포넌트에서, 전혀 다른 모습으로 나타났습니다. 메타데이터 DB로 MySQL을 쓰는 환경에서 dag-processor Pod가 불규칙하게 재시작되는 것입니다. 로그에는 다음과 같은 예외가 남았습니다.
sqlalchemy.exc.OperationalError: (MySQLdb.OperationalError)
(2013, 'Lost connection to server during query')
[SQL: SELECT dag_priority_parsing_request.id, ...]
dag-processor의 메인 루프가 우선 파싱 요청을 조회하는 도중 MySQL 커넥션이 끊긴 것입니다. 이 지점은 재시도나 예외 처리로 감싸여 있지 않아 프로세스가 그대로 종료됩니다. 같은 시각에 다른 쿼리들도 비슷한 예외를 내고 있었는데, 그 쿼리들은 재시도 로직에 걸려 컨테이너가 재시작되지 않았을 뿐 원인은 같아 보였습니다.
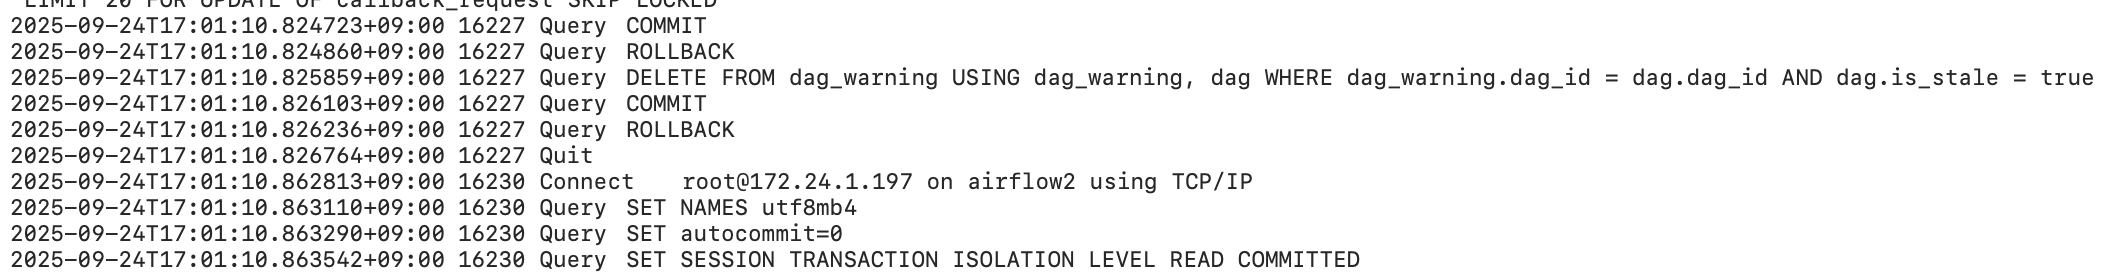
MySQL 쪽 general log를 확인해 보니, 문제가 발생한 시각에 그 커넥션으로 Quit 명령이 들어와 있었습니다. 서버가 타임아웃으로 끊은 것이 아니라, 클라이언트 쪽에서 정상 종료 절차를 밟은 것입니다. 그런데 dag-processor 메인 프로세스는 그 커넥션을 풀에서 계속 사용하고 있었습니다. 누군가가 마음대로 끊어 버린 커넥션을, 끊긴 줄 모른 채 사용하고 있었던 것입니다.
Airflow에서는 모든 DB 커넥션을 SQLAlchemy Engine 객체를 통해 관리하기 때문에, 원인 파악을 위해 connect 이벤트에 훅을 걸고 생성된 커넥션 객체에 weakref.finalize를 붙였습니다. 이로써 커넥션 객체가 소멸될 때 로그를 남깁니다.
@event.listens_for(engine, "connect")
def on_connect(dbapi_connection, connection_record):
    weakref.finalize(
        connection_record,
        lambda: print(f"{datetime.now().isoformat()} connection_record finalized in pid {os.getpid()}"),
    )
    weakref.finalize(
        dbapi_connection,
        lambda: print(f"{datetime.now().isoformat()} dbapi_connection finalized in pid {os.getpid()}"),
    )
결과는 다음과 같았습니다.
2025-09-22T13:41:30.352393 connection_record finalized in pid 417
2025-09-22T13:41:30.352403 dbapi_connection finalized in pid 417
PID 417은 파싱용으로 fork된 서브 프로세스였고, 소멸 시각은 MySQL 로그의 Quit 시각과 정확히 일치했습니다. 부모가 만든 커넥션 객체의 복사본이 자식에서 소멸되었고, 그 소멸이 부모의 소켓을 닫아 버린 것입니다.
mysqlclient 드라이버는 커넥션 객체가 해제될 때 서버에 COM_QUIT을 명시적으로 전송합니다. 자식이 보낸 Quit으로 서버는 세션을 종료하고, 부모는 다음 쿼리에서 2013 오류를 받습니다.
남은 의문은 커넥션 객체가 소멸된 원인입니다. 자식 프로세스에서 이 객체가 어떤 경로로 소멸되는지 찾아야 했습니다. 재현 조건도 의문이었습니다. 재시작이 꽤 자주 일어나고 영향도 치명적이었음에도, 기존에 리포트된 이슈가 없었습니다. 즉, 특정한 조건에서만 발생하는 이슈라고 추측했습니다.
원인 분석: CPython GC가 fork와 만날 때 생기는 문제
두 문제에는 공통점이 있습니다. fork로 만들어진 자식 프로세스가, 부모로부터 승계받았지만 자기가 쓰지는 않는 객체를 건드리고 있다는 점입니다. 첫 번째 증상에서는 그 결과가 페이지 복사(COW)로, 두 번째 증상에서는 객체 소멸(커넥션 종료)로 나타났습니다. 원인은 CPython의 메모리 관리 방식에 있습니다.
CPython의 두 가지 메모리 회수 장치
CPython은 메모리를 두 단계로 회수합니다. 첫 번째는 참조 카운트입니다. 모든 객체는 자기를 가리키는 참조의 수를 객체 헤더에 세어 둡니다. 이 수가 0이 되는 순간 객체는 즉시 해제됩니다. 대부분의 회수는 여기서 끝나지만, 두 객체가 서로를 가리키는 순환 참조는 바깥에서 아무도 쓰지 않아도 카운트가 0이 되지 않습니다.
이를 보강하는 두 번째 장치가 순환 GC입니다. 순환 GC는 다른 객체를 담을 수 있는 컨테이너 객체에만 PyGC_Head라는 추가 헤더를 붙여 추적합니다. 수집 때는 각 객체의 참조 카운트를 이 헤더에 복사한 뒤, 추적 객체끼리 주고받는 참조만큼 빼서 외부 참조가 남지 않는 고리를 찾아 그 객체들을 해제합니다.
비용을 줄이기 위해 추적 객체는 세대(generation) 0, 1, 2로 나뉩니다. 새 객체는 세대 0에 들어가고, 수집에서 살아남을 때마다 다음 세대로 올라갑니다. 각 수집은 세대별 카운터가 임계값(기본 700, 10, 10)을 넘는 순간 자동으로 시작됩니다. GC가 언제 돌지는 프로그램이 정하지 않습니다.
문제 1의 원인: 순환 GC가 PyGC_Head를 변경하여 COW가 발생한다
순환 GC의 핵심 단계는 '각 객체가 외부에서 얼마나 참조되는지'를 알아내는 것입니다. 이를 위해 GC는 수집 대상 세대의 모든 추적 객체를 순회하며 gc_refs라는 임시 값을 PyGC_Head에 기록하고, 다시 순회하며 이 값을 감소시킵니다.
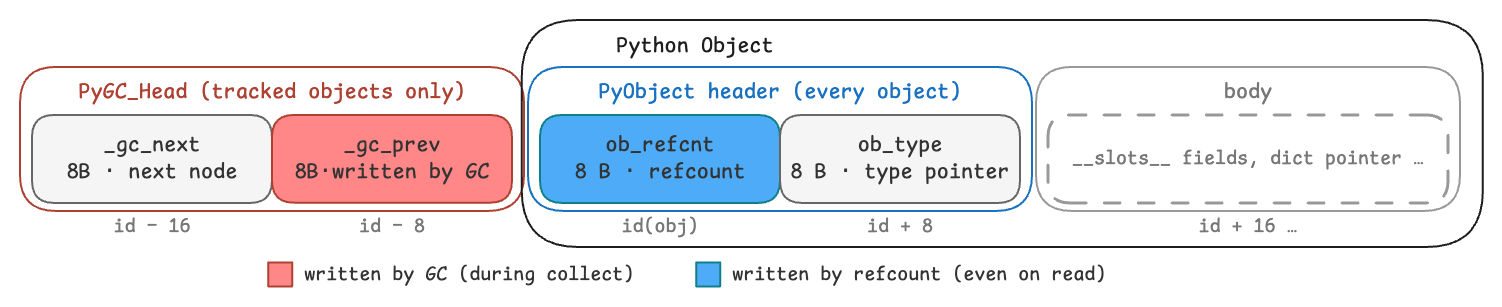
이제 자식 프로세스의 관점에서 생각해 보겠습니다. fork 직후 자식은 부모가 만든 수십만 개의 추적 객체를 그대로 승계합니다. 자식이 새 객체를 할당하다 임계값에 닿으면 순환 GC가 수행됩니다. 수집이 일어날 때마다 GC는 부모로부터 승계받은 객체를 포함한 모든 추적 객체의 PyGC_Head에 쓰기를 수행할 수 있습니다. 자식이 그 객체를 쓰는지와는 무관합니다.
그 결과 부모로부터 물려받은 객체가 놓인 거의 모든 페이지가 점진적으로 복사됩니다. 복사된 페이지는 자식의 메모리 사용량으로 산정되고, 그만큼 PSS가 상승합니다. 이것이 첫 번째 문제에서 메모리 사용량이 증가한 원인입니다.
fork의 Copy-on-Write 동작 원리
이 증상을 자세히 이해하기 위해 Copy-on-Write의 동작 원리를 조금 더 설명해 보겠습니다.
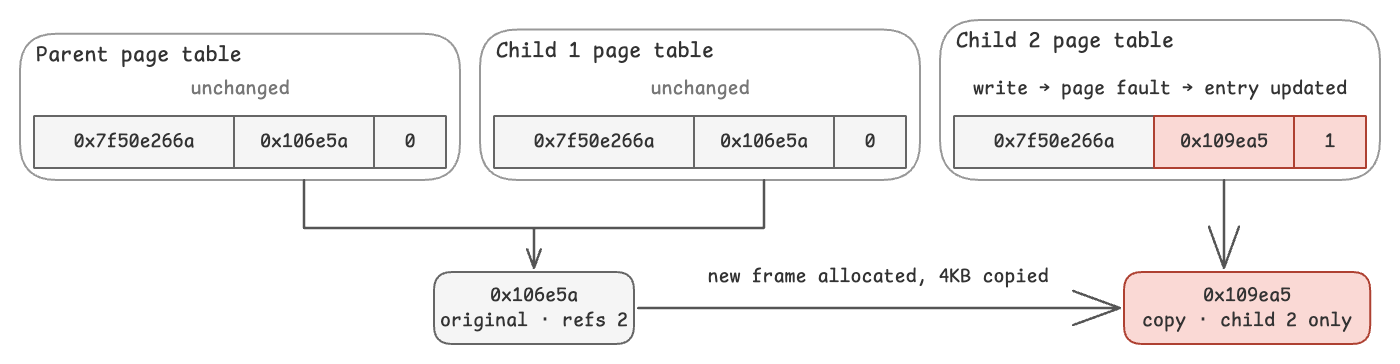
모든 프로세스는 각각 별도의 페이지 테이블을 가지고 있습니다. 페이지 테이블은 프로세스가 다루는 가상 페이지를 실제 물리 프레임 PFN(Page Frame Number)에 매핑한 테이블이며, 그 한 행이 PTE(Page Table Entry)입니다. PTE는 매핑 정보와 그 페이지에 쓰기가 가능한지를 포함합니다.
fork로 프로세스를 생성하는 경우 자식 프로세스는 부모의 페이지 테이블을 그대로 복사합니다. 즉, 물리 프레임은 복사하지 않으며 실제 메모리 사용량도 높이지 않습니다. 대신 커널이 물리 프레임의 참조 수를 올리고, 부모와 자식 양쪽의 PTE를 쓰기 불가 상태로 바꿉니다. 부모가 원본이고 자식이 사본인 것이 아니라, 둘 다 같은 프레임을 쓰기 금지 상태로 가리키고 있을 뿐입니다.
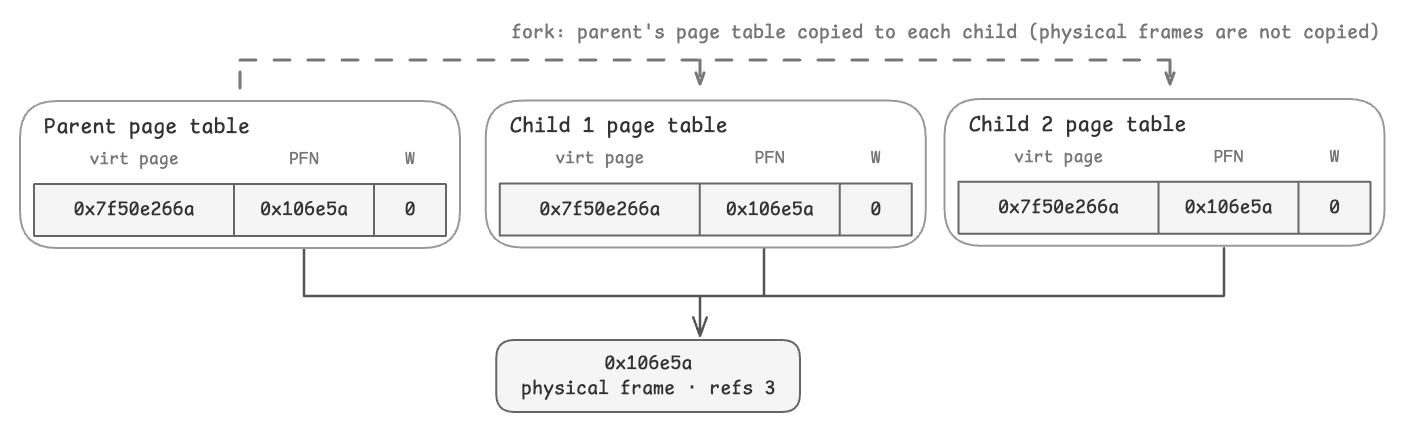
1편에서 확인했던 fork의 프로세스 생성 비용이 매우 낮은 이유가 여기에 있습니다. 물리적인 데이터를 복사하는 과정 없이 페이지 테이블만 복사합니다.
이후 어느 쪽이든 쓰기를 시도하면 page fault가 나고, 커널은 그 물리 프레임을 참조하는 프로세스가 몇 개인지 확인합니다. 둘 이상이면 새 물리 프레임에 복사하고(즉, COW가 발생하고) 쓰기를 시도한 프로세스의 PTE만 갱신합니다. 하나뿐이면 복사 없이 그 프레임에 바로 씁니다. 부모인지 자식인지는 상관이 없습니다. 부모가 먼저 쓰면 부모가 복사본을 받고, 마지막까지 쓰지 않은 쪽이 원본을 갖습니다.
실제 측정으로 확인
그럼 정말 순환 GC가 COW를 발생시키는지 실험으로 확인해 보겠습니다.
/proc/<pid>/pagemap을 확인하면 프로세스별 가상 페이지마다 매핑된 PFN을 얻을 수 있습니다. 같은 가상 주소에 대해 부모와 자식의 PFN이 같으면 공유 중인 것이고, 다르면 복사된 것입니다.
부모가 GC 추적 객체 30만 개를 만들고, 서로 다른 페이지에 있는 객체 20개의 주소를 기록한 뒤 fork를 실행합니다. 자식은 fork 직후 PFN을 읽고, gc.collect()를 한 번 호출하여 순환 GC를 강제로 수행한 뒤 다시 읽습니다. 자식이 객체에 접근하는 코드는 없습니다.
    virt page | parent PFN | child before collect | child after collect | parent after collect
--------------|------------|----------------------|---------------------|---------------------
  0x7f83934c3 |   0x106bcd |             0x106bcd |            0x107d09 |             0x106bcd
  0x7f83934c4 |   0x106bce |             0x106bce |            0x107d0a |             0x106bce
  0x7f83934c5 |   0x106bcf |             0x106bcf |            0x107d0b |             0x106bcf
가상 페이지 0x7f83934c3은 fork 직후 부모와 자식 모두 프레임 0x106bcd를 가리킵니다. 자식이 gc.collect()를 호출하고 나면 자식만 0x107d09로 바뀌고, 부모는 0x106bcd 그대로입니다. 자식은 이 객체들을 한 번도 건드리지 않았고 수거된 객체도 0개였지만, 순환 GC가 실행된 것만으로 20페이지 전부가 복사되었습니다. 즉, 순환 GC가 발생하면 그로 인해 객체가 놓인 페이지에 COW가 발생하는 것을 확인할 수 있습니다.
문제 2의 원인: 자식 프로세스의 순환 GC가 부모의 커넥션을 끊는다
두 번째 증상으로 돌아가 보겠습니다. 이제 '자식이 왜 부모의 커넥션 객체를 소멸시켰는가'를 설명할 수 있습니다.
Airflow는 fork된 자식이 부모의 DB 커넥션을 그대로 쓰지 못하도록, 자식 프로세스가 시작될 때 SQLAlchemy Engine의 커넥션 풀을 새로 만듭니다(원본 코드).
    if register_at_fork := getattr(os, "register_at_fork", None):
        # https://docs.sqlalchemy.org/en/20/core/pooling.html#using-connection-pools-with-multiprocessing-or-os-fork
        def clean_in_fork():
            _globals = globals()
            if engine := _globals.get("engine"):
                engine.dispose(close=False)
            if async_engine := _globals.get("async_engine"):
                async_engine.sync_engine.dispose(close=False)

        # Won't work on Windows
        # fork 직후 자식 프로세스에서 clean_in_fork 함수가 수행된다.
        register_at_fork(after_in_child=clean_in_fork)
이것 자체는 올바른 조치이며, SQLAlchemy도 fork와 함께 사용할 때 권장하는 방법입니다(SQLAlchemy 2.0 Documentation의 "Using Connection Pools with Multiprocessing or os.fork()" 참고). engine.dispose(close=False)를 수행하면 부모가 사용 중인 커넥션을 건드리지 않고 새로운 풀을 만들어 쓰게 됩니다. 따라서 자식이 물려받은 커넥션을 닫아 버려 부모가 쓰고 있는 커넥션이 의도치 않게 닫히는 현상을 방지합니다.
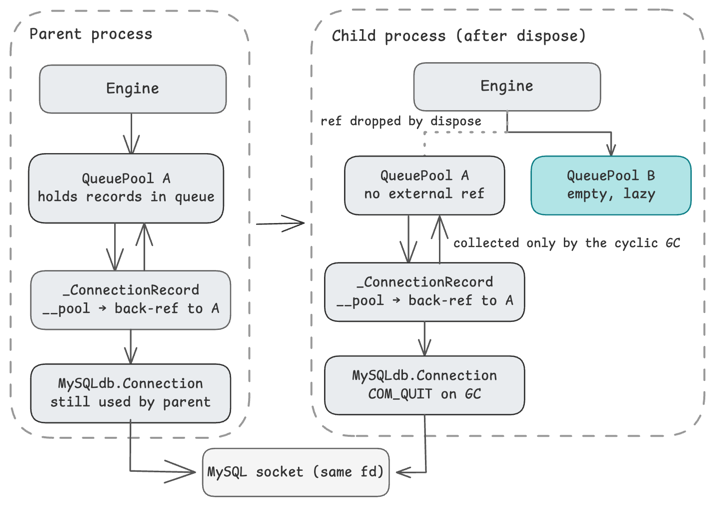
참조가 끊겼으니 바로 소멸될 것 같지만, SQLAlchemy의 풀과 커넥션 레코드는 서로를 참조하는 구조라서 참조 카운트만으로는 해제되지 않고 순환 GC가 돌아야 수거됩니다. 그래서 커넥션 종료 시각은 풀을 재생성한 시각이 아니라, 자식 프로세스에서 GC가 임계값에 도달한 시각입니다.
dynamic DAG generation을 사용하는 경우처럼 수행 시간이 길면 GC가 돌 확률이 높아지지만, 소규모 환경에서는 자식이 임계값에 닿기 전에 파싱을 마치고 종료합니다. 재현 조건이 규모에 따라 달랐던 이유입니다.
수거가 일어나면 mysqlclient의 커넥션 객체가 해제되고, 해제 과정에서 COM_QUIT이 부모와 공유하는 소켓으로 전송됩니다. 그 결과 자식 프로세스에서 발생한 GC 때문에 부모의 커넥션이 끊어집니다.
fork + 순환 GC 문제의 해결 방안 모색
해결 방안 1: fork 전에 무거운 모듈의 로드를 지연한다
원인을 알았으니 가장 먼저 떠올린 해결 방안은 자식이 물려받는 객체의 양 자체를 줄이는 것이었습니다. 승계받은 객체가 적으면 모든 객체에 COW가 발생하더라도 메모리가 크게 늘지 않기 때문입니다.
처음 접근한 방법은 scheduler의 루프가 돌기 전에 worker 프로세스들을 생성하는 것입니다. 또한 파일 최상단의 import 문은 그 모듈이 다시 import하는 모듈까지 연쇄적으로 로드합니다. 그래서 Memray 분석으로 많은 모듈을 로드하는 import 문을 식별해 worker 프로세스 생성 이후로 옮겼습니다. 아래는 그 구조를 간략히 나타낸 의사 코드입니다(원본 코드).
def _run_scheduler_job(args):
    # spawn workers before entering the scheduling loop
    spawn_workers()

    # lazy loading of heavy modules
    from airflow.jobs.job import Job, run_job
    from airflow.jobs.scheduler_job_runner import SchedulerJobRunner

    # starting the loop
    enable_health_check = conf.getboolean("scheduler", "ENABLE_HEALTH_CHECK")
    with _serve_logs(args.skip_serve_logs), _serve_health_check(enable_health_check):
        run_job(job=job_runner.job, execute_callable=SchedulerJobRunner()._execute)
실제로는 잘 동작하지 않았는데, 두 가지 큰 문제가 있었습니다.
우선 줄일 수 있는 양에 한계가 있었습니다. Airflow는 각 컴포넌트를 airflow scheduler처럼 CLI로 기동합니다. 이 과정에서 airflow 패키지의 __init__.py와 __main__.py가 실행되고, SQLAlchemy, FastAPI 같은 무거운 라이브러리가 로드되어 그것만으로 100MB를 차지합니다.
또한 worker의 task 처리 성능이 저하되어 처리량이 감소했습니다. 1편의 내용처럼 무거운 모듈의 import를 fork 이후로 미뤘기 때문에 각 task에서 그 모듈을 전부 import해야 했고, 그만큼 task 처리 성능이 낮아졌습니다. 1분당 100개 넘는 task를 처리하던 기존 로직이 60~70개의 task밖에 처리할 수 없게 되었습니다.
해결 방안 2: gc.freeze를 적용한다
결국 근본적으로 COW를 방지하는 해결책을 찾아야 했습니다. 자식 프로세스에서 GC를 꺼 버리는 것(gc.disable())이 가장 단순하지만, 그러면 자식이 만드는 순환 참조 객체가 수거되지 않아 다른 종류의 누수가 생길 수 있었습니다.
CPython은 정확히 이 용도로 3.7 버전부터 gc.freeze()를 제공합니다. Python 공식 문서는 fork를 사용하는 프로그램에 이 함수의 사용을 명시적으로 권장하고 있습니다.
If a process will
fork()withoutexec(), avoiding unnecessary copy-on-write in child processes will maximize memory sharing and reduce overall memory usage.
호출 시점에 GC가 추적하는 모든 객체를 '영구 세대(permanent generation)'로 옮기고, 이후의 수집에서는 이 세대를 무시합니다. 즉, 호출 시점에 존재하는 모든 객체를 GC 대상에서 제외하는 것입니다.
gc.freeze()는 Instagram 엔지니어들이 자사의 fork 기반 웹 서버에서 정확히 같은 COW 문제를 겪고 CPython에 직접 기여한 기능입니다. 그 배경은 Instagram Engineering 블로그 글에 정리되어 있습니다.
따라서 gc.freeze를 fork 직전에 수행하면 앞의 두 문제를 모두 해결할 수 있습니다.
- 순환 GC의 대상이 되지 않아
PyGC_Head가 변경되지 않으므로, COW가 발생하지 않습니다. - 부모 프로세스의 객체가 수거되지 않으므로, 부작용(커넥션 종료)이 생기지 않습니다.
'GC 대상에서 제외되면 그 객체들의 메모리는 영영 해제되지 않는 것 아닌가?'라는 의문이 들 수 있습니다. 순환 GC의 대상이 아닐 뿐, 참조 카운트에 의한 해제는 여전히 동작하기 때문에 상황에 따라 수거가 가능합니다.
호출 비용도 거의 없는 수준입니다. 같은 세대의 객체는 이중 연결 리스트로 연결되어 있고, 그 정보를 PyGC_Head에서 관리합니다. freeze는 리스트 세 개를 영구 세대 리스트 뒤에 이어 붙이는 것뿐입니다. 헤더에 쓰기가 일어나는 곳은 각 리스트의 첫 노드와 끝 노드, 그리고 리스트 헤드 정도여서 O(1) 작업입니다.
해결 방안의 적용과 결과
LocalExecutor 적용
LocalExecutor의 실제 적용에는 한 가지 조건이 더 붙습니다. worker 프로세스는 freeze된 상태로 살아가야 하지만, 부모인 scheduler는 freeze되면 안 됩니다. scheduler는 스케줄링 루프를 돌며 계속 객체를 만들고 버리는데, 그 객체들이 영구 세대에 묶여 있으면 scheduler 쪽에서 새로운 누수가 생길 수 있습니다. 따라서 아래와 같이 적용했습니다.
def _spawn_workers(self, n: int):
    gc.freeze()
    try:
        for _ in range(n):
            self._spawn_worker()
    finally:
        gc.unfreeze()
worker 프로세스를 생성하기 직전에 gc.freeze()를 호출합니다. 자식은 부모의 메모리를 그대로 승계하므로, 자식이 물려받은 모든 객체는 영구 세대에 있고 세대 0~2는 비어 있습니다. 이후 자식이 task를 실행하며 객체를 만들면 그것들만 세대 0에 들어가고 순환 GC의 대상이 됩니다.
필요한 만큼 worker 프로세스를 생성한 후, gc.unfreeze()로 기존 객체들을 GC 적용 세대로 되돌립니다. 영구 세대로 옮겨졌던 기존 객체들이 다시 GC 대상으로 복귀합니다. 이후 원래대로 세대별 GC를 수행하고, 스케줄링 루프에서 만든 객체들도 정상적으로 수거됩니다.
이 unfreeze 때문에 부모와 자식 사이에 차이가 생깁니다. 자식의 객체는 freeze된 상태라 PyGC_Head가 변하지 않지만, 부모의 객체는 순환 GC에 의해 변경되므로 부모 쪽에서만 COW가 발생합니다. 다만 기존에는 모든 자식에게서 각각 발생하던 복사가, 이 적용으로 부모 프로세스에서 1회만 발생하도록 바뀐 것입니다.
실측해 보니 GC freeze/unfreeze 사이클의 비용은 각각 19μs, 10μs 정도로, 위에서 설명한 바와 같이 영향을 주지 않는 수준이었습니다.
이 변경은 Airflow에 PR #58365로 추가했고 3.1.4에 백포트되었습니다.
dag-processor 적용
dag-processor의 경우 파싱용으로 fork된 서브 프로세스는 대부분 수명이 매우 짧아서, COW가 일어나기 전에 종료됩니다. 하지만 dynamic DAG generation을 하는 경우 길게는 1~2분 넘게 지속될 수 있고, 그런 DAG 여러 개가 동시에 수행되면 일시적인 메모리 스파이크를 겪을 수도 있습니다. 문제 2에서 언급한 MySQL 커넥션 문제도 해결할 수 있을 것으로 예상해, gc.freeze를 적용하기로 논의했습니다.
처음에는 LocalExecutor처럼 freeze/unfreeze 사이클을 적용해 보았으나, 오히려 부모의 메모리가 계속 증가했습니다. 원인은 gc.freeze()가 세대 0, 1, 2 각각의 수집 카운터를 모두 0으로 리셋한다는 데 있습니다. 순환 GC는 이 카운터가 임계값을 넘어야 시작되는데, dag-processor는 파일마다 fork를 실행하므로 두 fork 사이에 카운터가 임계값에 닿기 전에 다시 0이 됩니다. 그 사이 부모가 파싱 결과를 처리하며 만든 순환 참조 가비지는 gc.unfreeze()에 의해 전부 세대 2로 옮겨집니다. 세대 2는 full collection만 훑는 곳이고, 그 full collection은 트리거가 계속 리셋되어 영영 오지 않으니 가비지가 회수되지 않고 단조 증가한 것입니다.
LocalExecutor는 worker가 부족할 때 아주 가끔 fork를 실행하므로 카운터 리셋의 영향이 없지만, dag-processor는 fork가 GC 임계값 도달보다 훨씬 자주 일어나 GC가 사실상 꺼진 것과 같은 상태가 됩니다.
freeze 직전에 gc.collect()를 강제하면 가비지가 세대 2로 승격되기 전에 회수되어 해결되지만, fork마다 full collection을 도는 비용 때문에 채택하지 않았습니다.
대신 파싱 루프에 진입하기 직전에 한 번만 freeze하고 unfreeze는 하지 않았습니다. 막아야 할 COW는 import airflow와 초기화 과정에서 만들어진 객체들의 것이고, 이들은 루프 전에 이미 존재하기 때문입니다. 이후 부모가 만드는 객체는 정상적으로 수거됩니다.
이 변경은 Airflow에 PR #60505로 추가했습니다.
CeleryExecutor 적용
CeleryExecutor가 띄우는 Celery worker의 메인 프로세스는 worker_concurrency(기본 16)만큼의 ForkPoolWorker를 fork로 만들어 두고 task를 분배합니다. 이 프로세스들은 task마다 폐기되지 않고 상주하며, LocalExecutor와 마찬가지로 시간이 지남에 따라 COW로 메모리가 증가하는 현상을 확인할 수 있었습니다.
적용은 Celery가 제공하는 시그널을 이용했습니다. 1편에서 소개한 celery_import_modules 시그널에서 무거운 모듈의 preload가 끝난 직후 gc.freeze()를 호출합니다. ForkPoolWorker는 그 이후에 fork되므로 preload된 객체가 영구 세대에 들어간 상태를 승계하고, 그 결과 COW가 발생하지 않습니다.
LocalExecutor와 마찬가지로 unfreeze도 적용했습니다. Celery 시그널 중 @worker_ready.connect를 사용해, worker가 초기화를 끝낸 시점에 unfreeze를 수행하도록 했습니다.
이 변경은 Airflow에 PR #62212로 추가했습니다.
측정 결과
세 컴포넌트 모두 적용 전후의 PSS와 컨테이너 전체 메모리 사용량을 비교했습니다. workload가 달라 측정 환경도 컴포넌트마다 달랐습니다.
LocalExecutor 메모리 사용량
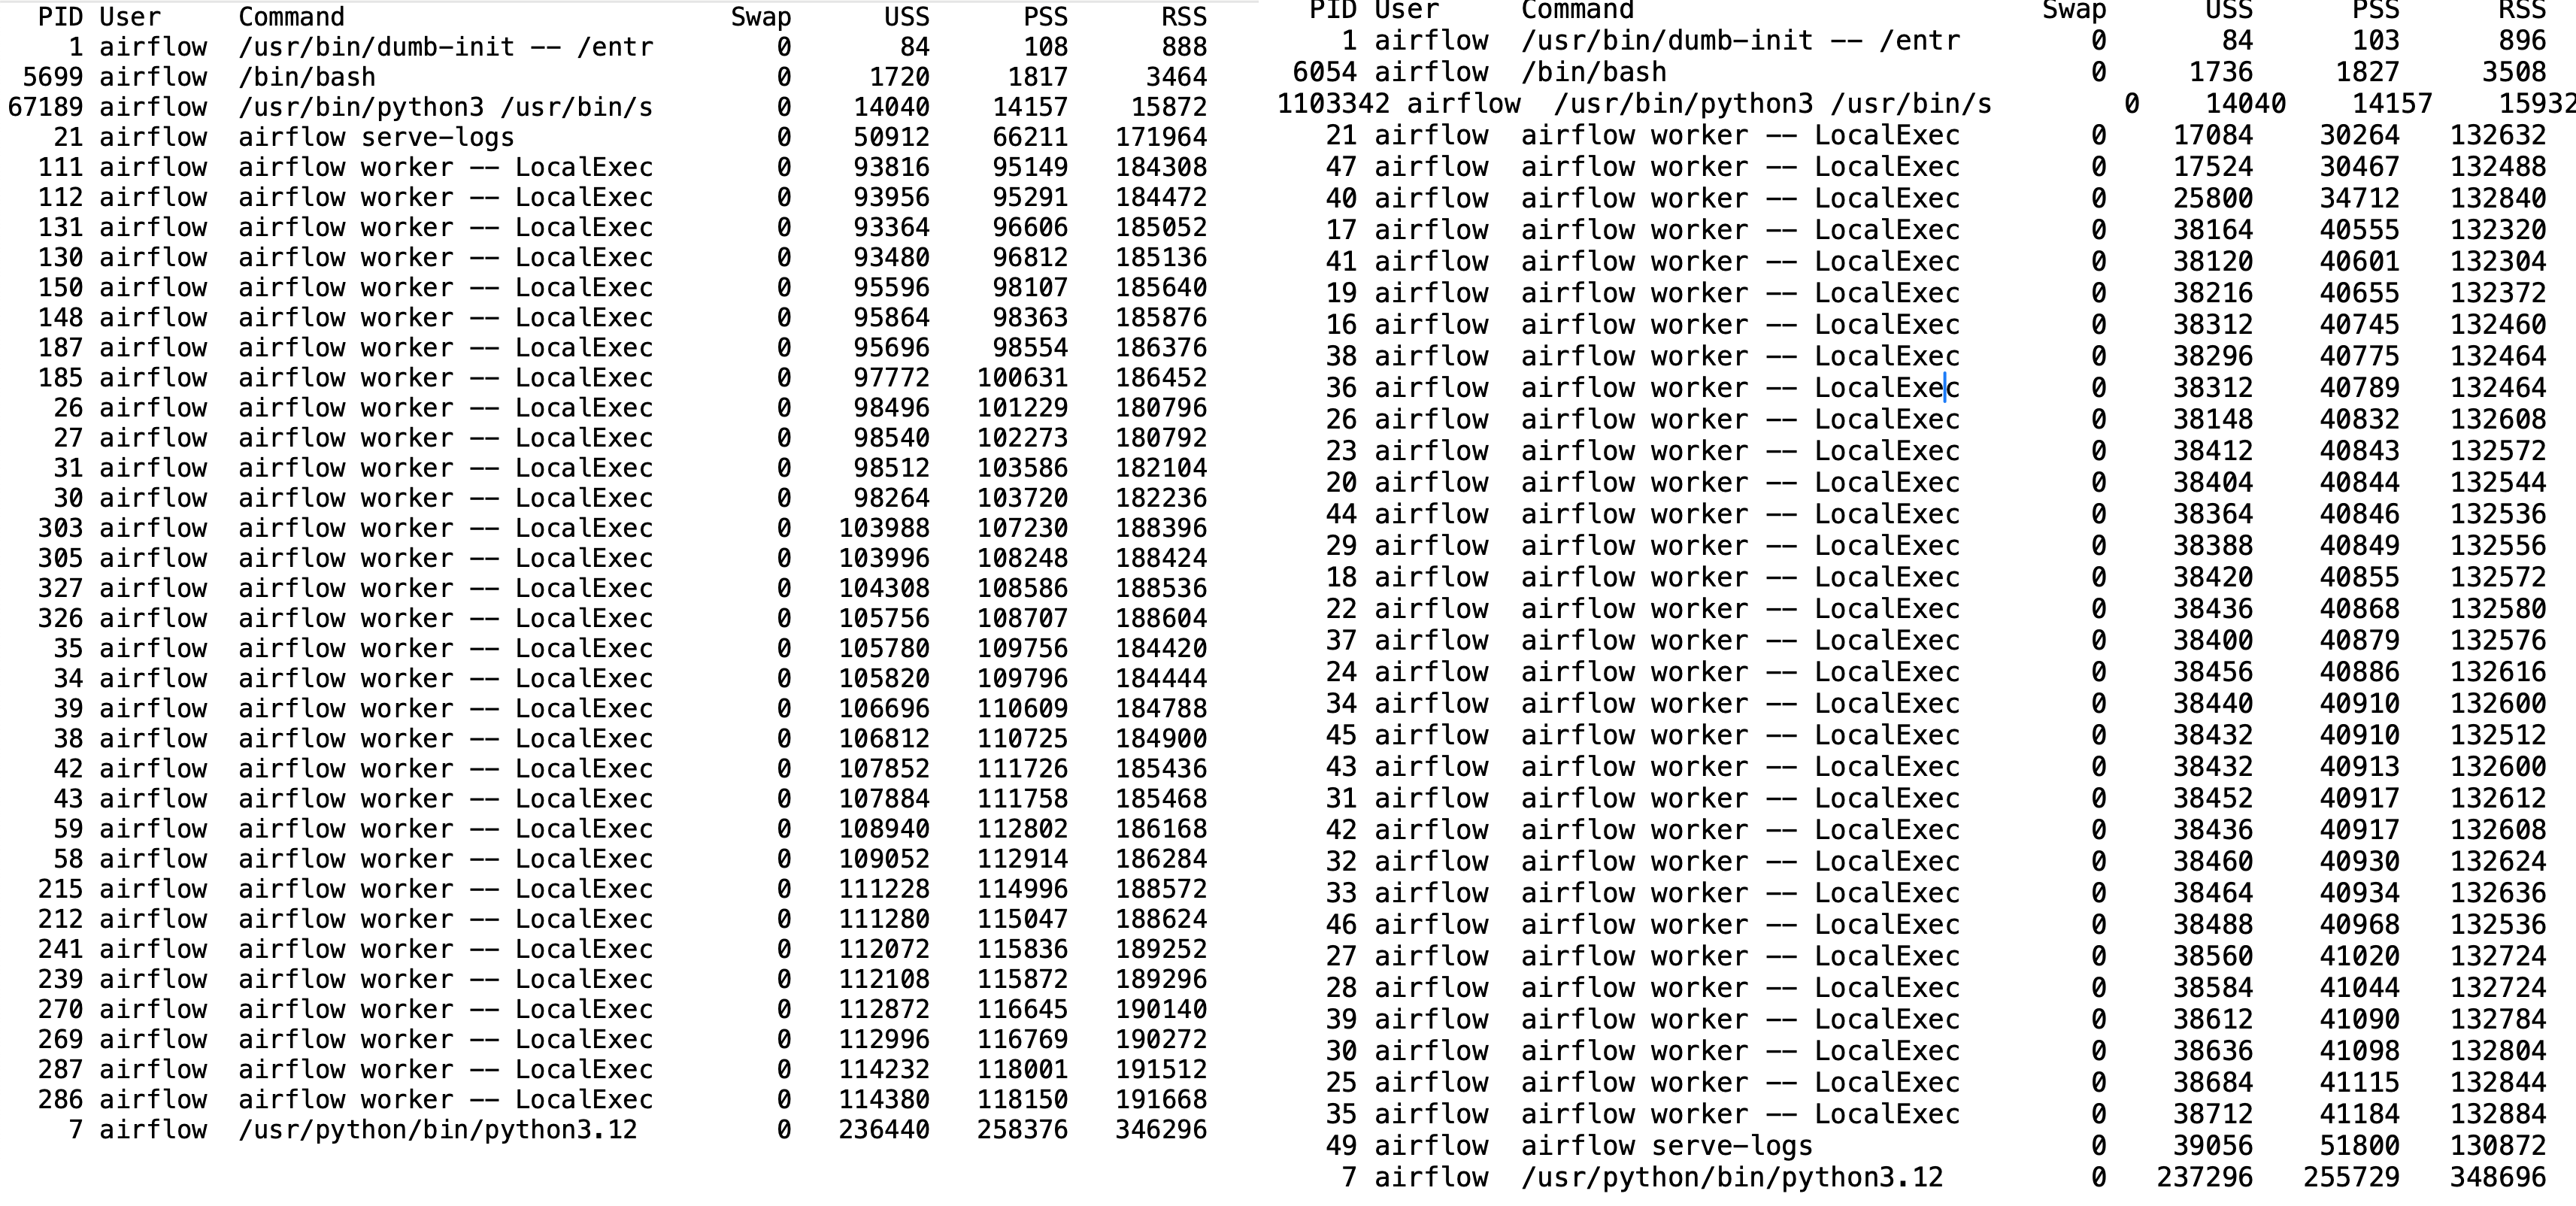
LocalExecutor는 분당 500개 task를 12시간 동안 실행하는 환경에서 측정했습니다. 적용 전에는 모든 worker가 100MB 이상으로 수렴했지만, 적용 후에는 40MB 수준에서 안정화되었습니다. worker 32개를 띄운 scheduler 컨테이너 전체로 보면 PSS 합계가 약 3.6GB에서 약 1.5GB로, 약 2.1GB(58%)가 줄었습니다.
dag-processor 메모리 사용량
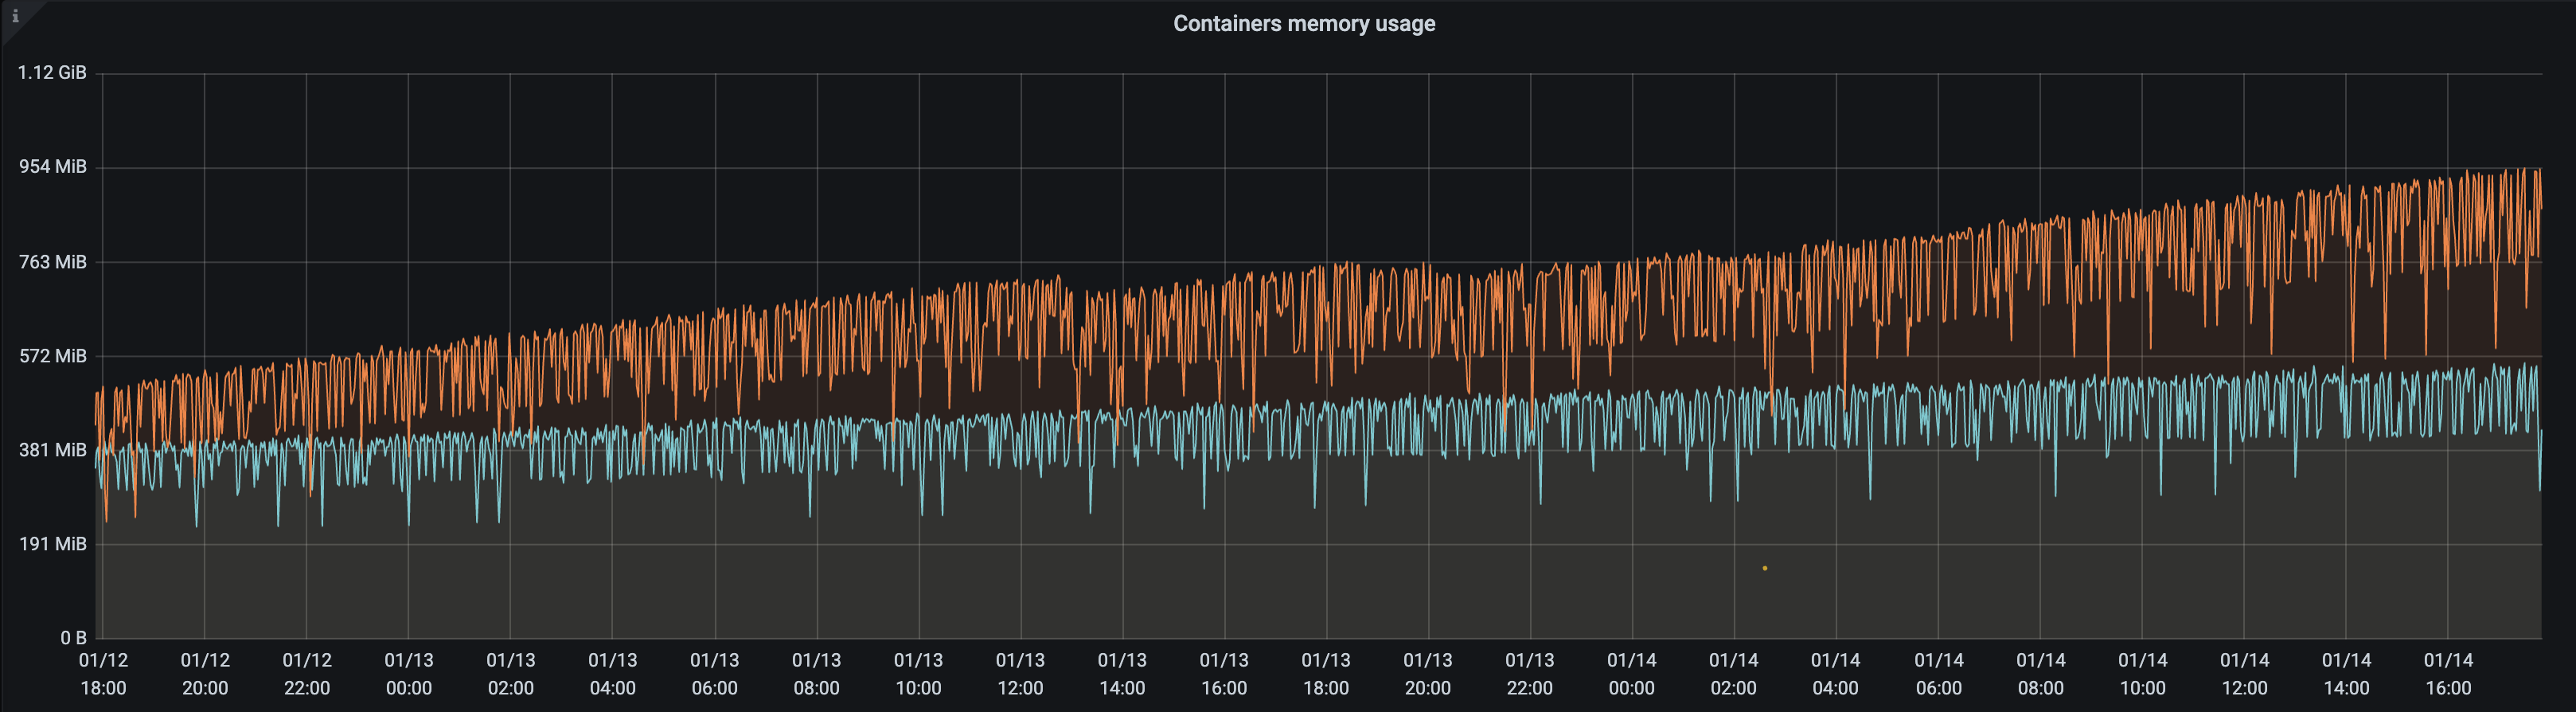
dag-processor는 저희가 운영하는 플랫폼과 비슷한 환경에서 측정했습니다. 운영 중인 DAG 파일 중 dynamic DAG 파일 5개를 파싱하며, 파일당 평균 40개의 DAG를 생성합니다.
패치 전 버전(주황색)보다 패치를 적용한 버전(파란색)의 메모리 사용량이 훨씬 낮은 것을 확인할 수 있습니다. 또한 문제 2의 해결까지 확인했습니다.
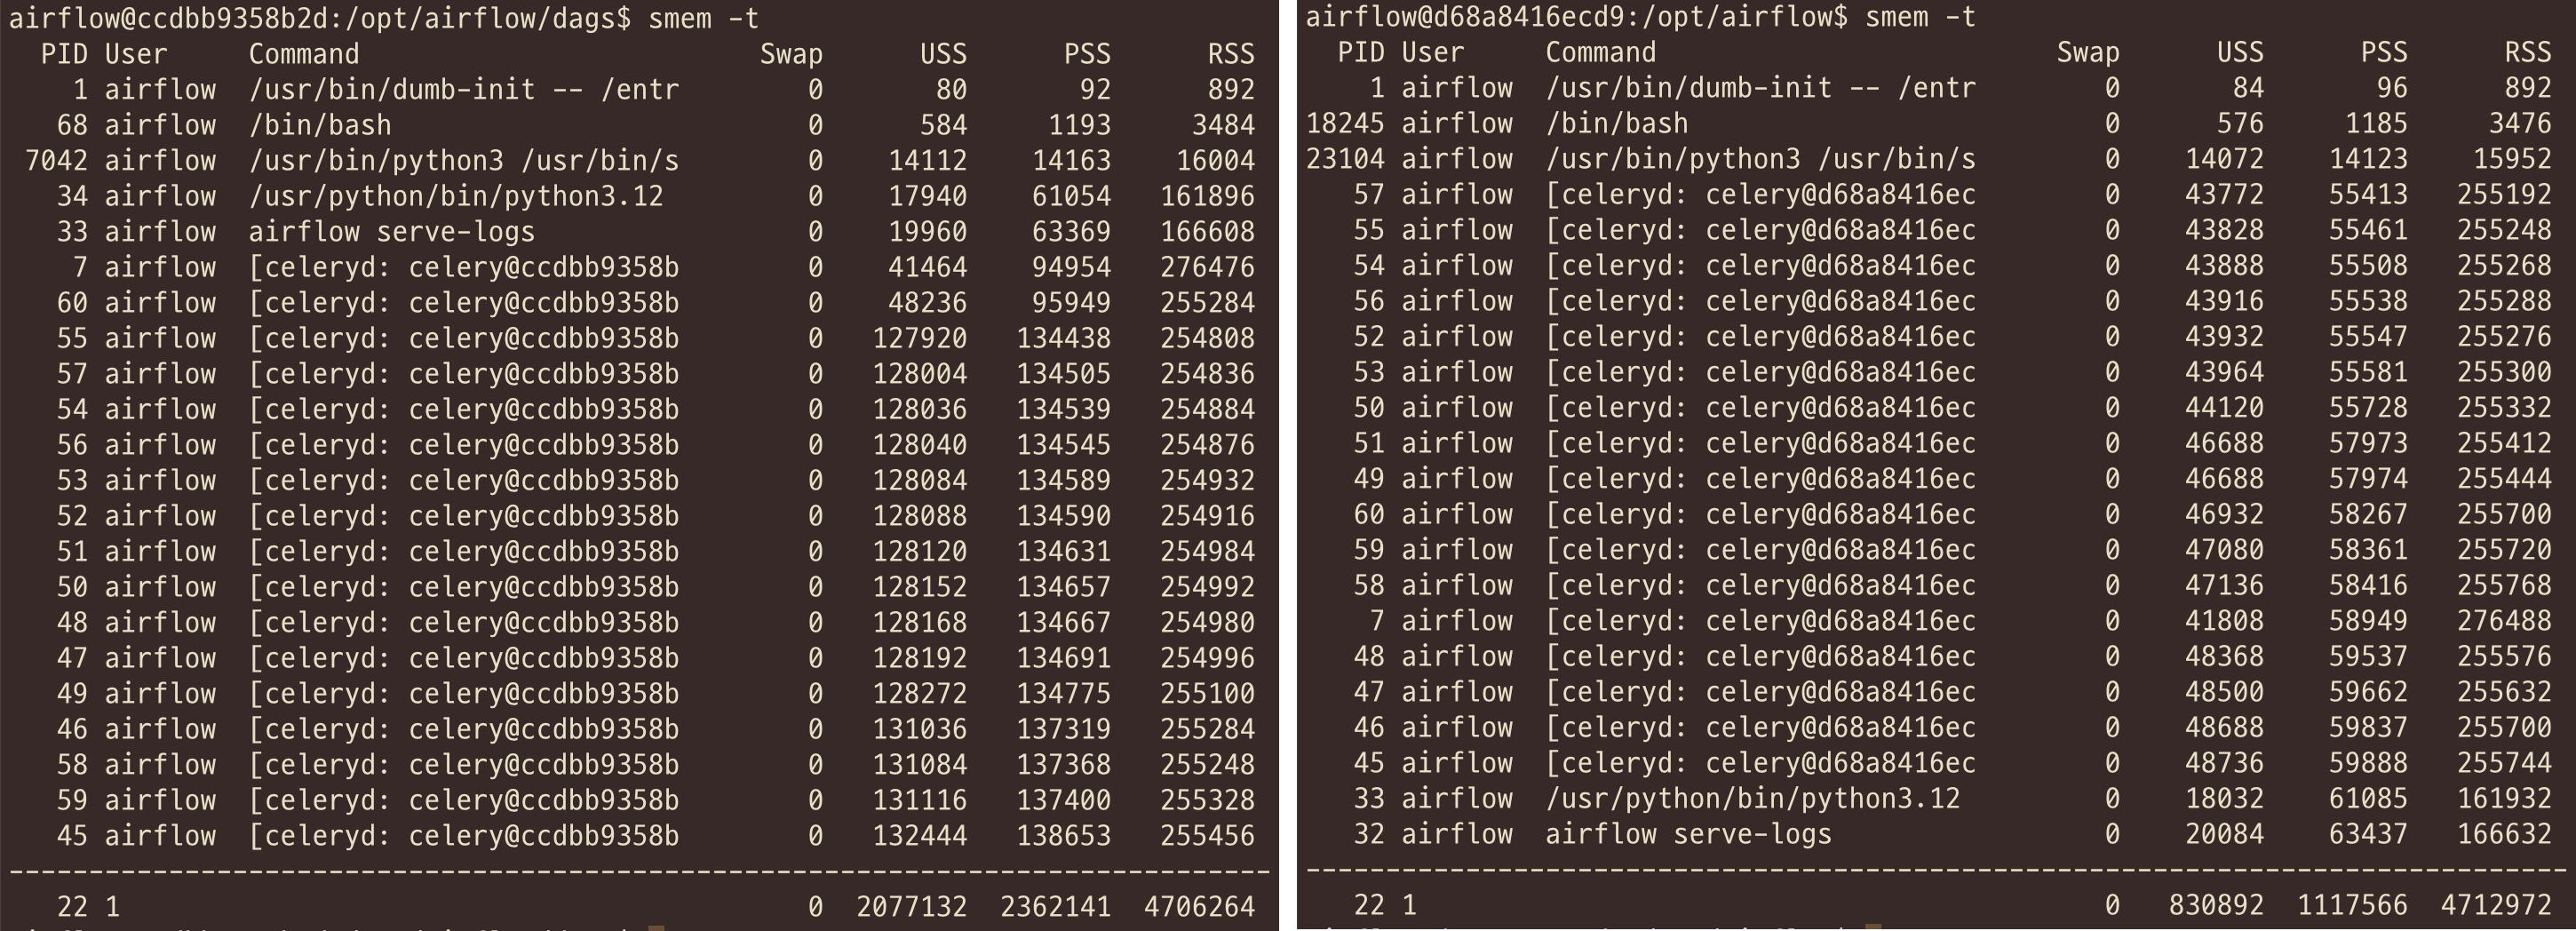
CeleryExecutor 메모리 사용량
CeleryExecutor는 LocalExecutor와 마찬가지로 각 프로세스의 PSS와 전체 컨테이너 메모리 사용량이 줄어들었습니다. worker 컨테이너 하나의 메모리 사용량은 2.25GB에서 1.07GB로 감소했습니다.
마치며
해결 방안 적용 결과를 정리하면 다음과 같습니다.
- LocalExecutor: 프로세스당 PSS가 100MB에서 40MB로 감소. 컨테이너 전체의 PSS 합계가 약 3.6GB에서 약 1.5GB로, 약 2.1GB(58%) 감소.
- dag-processor: DAG 파싱 시 메모리 스파이크 감소. Pod가 재시작되던 문제 해결.
- CeleryExecutor: 하나의 worker 컨테이너의 메모리 사용량이 2.25GB에서 1.07GB로 감소
이 세 변경은 각각 Airflow 3.1.4와 3.1.7, Celery provider 3.17.2에 포함되어 있습니다. Airflow 3를 운영하며 비슷한 메모리 패턴을 보고 있다면, 이 버전 이상으로 올리는 것만으로도 효과를 볼 수 있을 것입니다.
이 문제는 Airflow만의 것이 아닙니다. gunicorn의 preload와 같이 무거운 모듈을 로드하고 fork로 자식을 만드는 Python 서비스라면 같은 패턴이 나타날 수 있습니다. 그런 경우에는 gc.freeze를 검토할 수 있습니다. 다만 fork가 GC 임계값 도달보다 잦은 프로세스에서는 freeze/unfreeze를 반복하지 않아야 한다는 점이 중요합니다.
이 밖에도 이 글에서 자세히 다루지는 않았지만, 3.x 버전의 메모리 안정화를 위한 추가 작업도 수행했습니다.
- Fix memory growth from pathlib sys.intern in long-running processes (#65706)
- Fix memory leak in LocalExecutor caused by unreleased file descriptor locks (#65121)
- Fix memory leak in Client via SSL context creation (#57334)
- fix serialize_template_field handling callable value in dict (#63871)
- add static checker for preventing to increase dag version (#59430)
그 결과 이러한 변경이 모두 반영된 3.3.0에서는 저희 환경 기준으로 worker 내부의 메모리 누수가 발견되지 않았으며, 저희 팀 또한 3.x 버전 도입을 더욱 적극적으로 검토하고 있습니다.