요약
오늘은 Amazon Aurora PostgreSQL의 새로운 기능을 발표합니다. 이 기능을 사용하면 기존 PostgreSQL 애플리케이션 및 도구로 운영 데이터와 데이터 레이크에 Apache Iceberg 및 Apache Parquet 형식으로 저장된 데이터를 함께 직접 쿼리할 수 있습니다. 데이터 레이크의 정형 데이터를 운영 데이터베이스로 추출, 변환, 적재(ETL)할 필요가 없어 운영 복잡성을 줄이고 애플리케이션 개발을 간소화할 수 있습니다. 또한 Auro…
본문
Amazon Aurora PostgreSQL, Apache Iceberg 및 Parquet 데이터 레이크 직접 쿼리 가능오늘은 Amazon Aurora PostgreSQL의 새로운 기능을 발표합니다. 이 기능을 사용하면 기존 PostgreSQL 애플리케이션 및 도구로 운영 데이터와 데이터 레이크에 Apache Iceberg 및 Apache Parquet 형식으로 저장된 데이터를 함께 직접 쿼리할 수 있습니다. 데이터 레이크의 정형 데이터를 운영 데이터베이스로 추출, 변환, 적재(ETL)할 필요가 없어 운영 복잡성을 줄이고 애플리케이션 개발을 간소화할 수 있습니다. 또한 Aurora PostgreSQL을 사용하여 Iceberg REST Catalog(IRC) 호환 카탈로그에서 관리되는 데이터 레이크의 데이터를 쿼리할 수 있으므로, 데이터를 이동하거나 복제하지 않고도 다양한 분석 시스템의 데이터에 액세스할 수 있습니다. 실시간 대시보드를 구동하거나, 과거 컨텍스트를 활용해 트랜잭션을 보강하거나, 실시간 데이터와 보관된 데이터를 모두 기반으로 추론하는 AI 에이전트를 구축하는 등 이제 이 모든 작업을 익숙한 단일 인터페이스에서 수행할 수 있습니다.
이전에는 애플리케이션에서 Aurora의 최근 트랜잭션 데이터를 Amazon S3에 저장된 과거 기록과 결합해야 하는 경우, 일반적으로 역방향 ETL 파이프라인을 구축했습니다. 이 방식은 데이터를 복제하고 인프라 비용을 증가시키며 모든 데이터의 동기화를 유지하기 위해 지속적인 엔지니어링 작업이 필요했습니다. 애플리케이션에 AI 에이전트를 점점 더 많이 통합할수록 이러한 문제는 더욱 커집니다. 에이전트에 필요할 수 있는 모든 데이터세트를 예측하고 미리 복제하는 것은 현실적으로 어렵기 때문입니다.
DuckDB 프로젝트를 유지 관리하는 팀인 DuckLabs가 최근 Amazon에 합류했으며, 이 기능은 DuckDB의 효율성이 AWS 서비스에 어떻게 통합되고 있는지를 보여주는 사례입니다. 이제 DuckDB가 Aurora PostgreSQL에 직접 내장되어, 단일 쿼리로 실시간 운영 데이터(커밋되지 않은 쓰기 포함)와 데이터 레이크의 데이터를 함께 쿼리할 수 있습니다. 쿼리 처리는 Aurora 내에서 이루어지므로 추가 네트워크 홉이나 데이터를 복제하는 ETL 파이프라인이 필요하지 않습니다. AWS Glue Data Catalog를 통해 관리되는 Apache Iceberg 테이블뿐 아니라 Amazon S3 및 S3 Tables에 저장된 Parquet 및 Iceberg 데이터도 쿼리할 수 있습니다. 익숙한 PostgreSQL 구문과 기존 애플리케이션 및 도구를 사용하여 이 모든 작업을 수행할 수 있습니다.
DuckDB의 빠른 속도와 간편함을 Aurora PostgreSQL에 직접 도입하게 되어 기쁩니다. 이를 통해 사용자와 에이전트는 이미 사용 중인 익숙한 PostgreSQL 애플리케이션, 도구 및 엔드포인트로 운영 데이터와 Iceberg 데이터를 쿼리하고 결합할 수 있습니다. 이 기능은 DuckDB를 기반으로 구축되므로, 향후 이 오픈 소스 엔진의 개선을 통해 Aurora와 다른 AWS 서비스의 성능과 기능도 지속적으로 향상될 수 있습니다.
새로운 기능
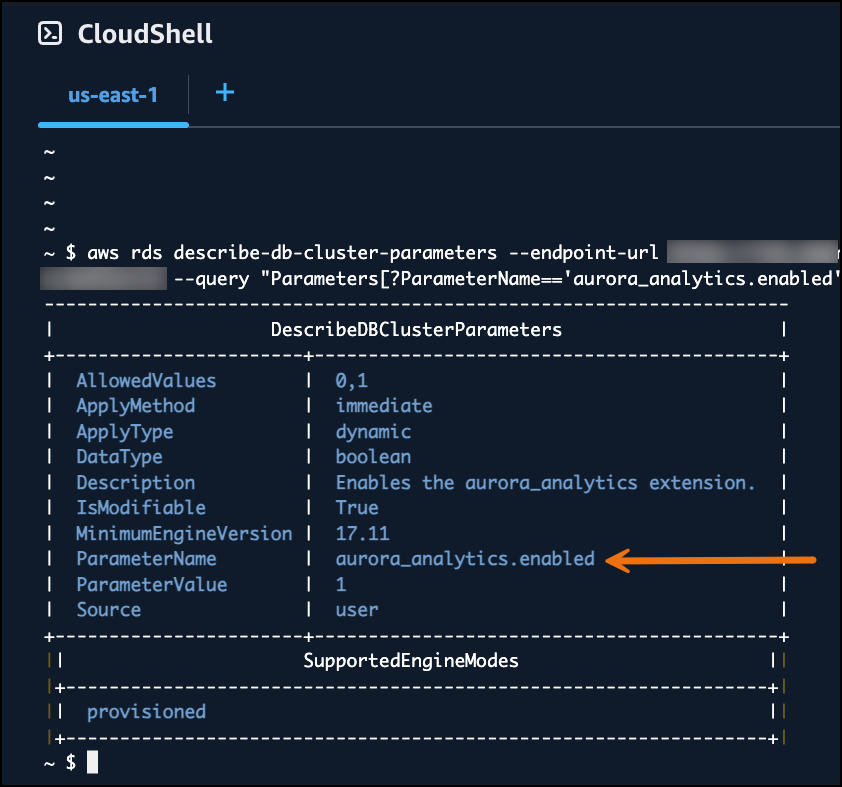
이 기능은 Aurora PostgreSQL의 두 메이저 버전인 17(17.11부터)과 18(18.6부터)에서 지원됩니다. 이 기능을 사용하려면 Aurora PostgreSQL 클러스터를 생성하고, AuroraAnalytics 기능으로 IAM 역할을 연결한 다음, aurora_analytics 확장을 활성화합니다. IAM 역할은 Aurora에 Amazon S3와 AWS Glue Data Catalog의 데이터에 액세스할 수 있는 권한을 부여합니다. 그런 다음 데이터 레이크의 Iceberg 또는 Parquet 데이터를 가리키는 외부 테이블을 생성하고, 익숙한 PostgreSQL 구문을 사용하여 해당 테이블을 쿼리합니다. 이 설정은 Amazon RDS 콘솔 또는 psql과 같은 PostgreSQL 클라이언트를 통해 완료할 수 있습니다. 이 절차는 Aurora PostgreSQL 설명서에 자세히 설명되어 있습니다.
AWS Glue Data Catalog 페더레이션을 통해 외부 IRC 호환 카탈로그 전반의 데이터를 쿼리할 수 있습니다. 외부 카탈로그를 Glue에 한 번 등록한 다음, Glue 네이티브 테이블과 동일한 방식으로 쿼리하려는 테이블에 대한 외부 테이블을 생성합니다. 그러면 단일 쿼리로 Aurora에 저장된 데이터와 여러 카탈로그에 등록된 Iceberg 테이블을 조인할 수 있으므로, 데이터를 이동하거나 기존에 투자한 카탈로그를 교체하지 않고도 애플리케이션에서 통합된 뷰를 얻을 수 있습니다.
또한 Aurora는 필요한 데이터만 읽도록 조건자 푸시다운 및 열 프루닝과 같은 최적화를 적용합니다. 이를 통해 기반 데이터의 양이 늘어나도 쿼리 효율성을 유지할 수 있습니다. 자주 액세스하는 데이터는 Aurora 인스턴스에 캐시되므로, 이후 동일한 데이터를 쿼리하면 결과가 더 빠르게 반환됩니다. 쿼리별로 이러한 동작을 확인하려면 aurora_analytics_stat_statements()를 사용할 수 있습니다. 이 함수는 스캔한 행 수, Amazon S3에서 읽은 바이트 수, 캐시 적중 횟수 등의 지표를 보고합니다.
직접 쿼리의 작동 방식을 확인하기 위해 psql을 사용하여 Aurora PostgreSQL 데이터베이스에 연결하고 확장을 생성했습니다.
CREATE EXTENSION aurora_analytics;단계별 설명을 위해 간단한 금융 시나리오를 설정했습니다. Aurora에는 최근 7일간의 고객 거래가 저장된 recent_transactions 테이블이 있고, Amazon S3에는 5년간의 과거 거래 데이터가 저장된 Parquet 파일이 있습니다. Aurora가 과거 데이터를 인식할 수 있도록 S3의 Parquet 파일을 가리키는 외부 테이블을 생성했습니다.
CREATE FOREIGN TABLE transaction_history ()
SERVER aurora_analytics_server
OPTIONS (
 location 's3://<my-bucket>/finance/transaction_history.parquet',
 format 'parquet'
);
SQL 문 CREATE FOREIGN TABLE의 빈 괄호에 주목하세요. Aurora는 Parquet 파일 메타데이터에서 스키마를 자동으로 읽으므로 열을 수동으로 정의할 필요가 없습니다. 테이블이 많은 워크로드에서는 테이블을 하나씩 생성할 필요가 없습니다. IMPORT FOREIGN SCHEMA 문 하나로 AWS Glue Data Catalog 데이터베이스의 모든 Iceberg 또는 Parquet 테이블에 대한 외부 테이블을 일괄 생성하고 스키마를 자동으로 추론할 수 있습니다.
두 테이블을 모두 준비한 후, Aurora의 최근 운영 데이터와 S3의 과거 데이터를 결합하는 단일 쿼리를 실행했습니다.
SELECT merchant, category, amount, transaction_date, 'recent' AS source
FROM recent_transactions
WHERE customer_id = 'C-1001'
UNION ALL
SELECT merchant, category, amount, transaction_date, 'historical' AS source
FROM transaction_history
WHERE customer_id = 'C-1001'
 AND transaction_date >= CURRENT_DATE - INTERVAL '5 years'
ORDER BY transaction_date DESC
LIMIT 15;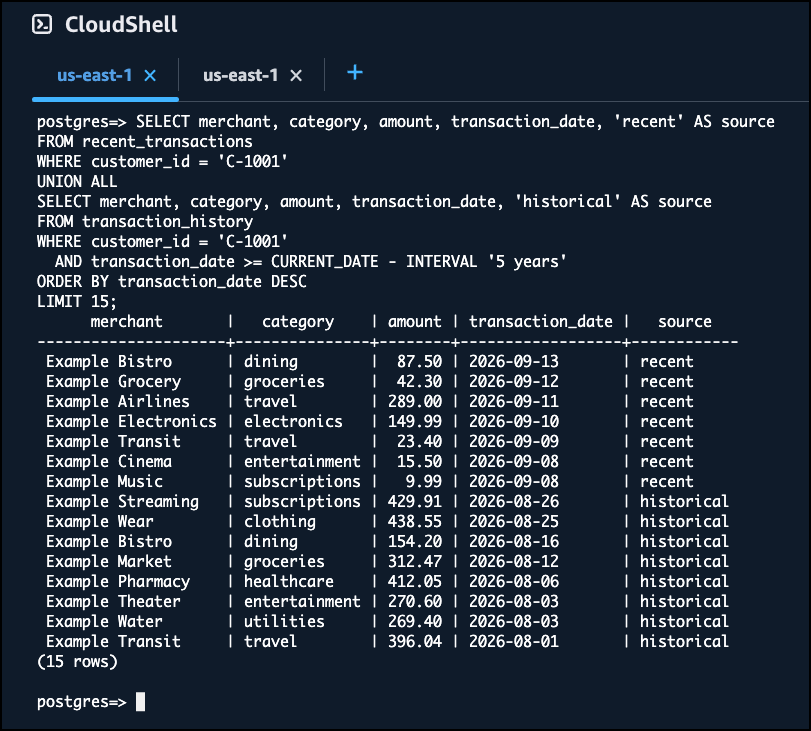
결과에는 최근 거래와 과거 거래가 하나의 결과 집합으로 표시됩니다. 가장 최근의 7개 행은 Aurora에서 가져오고, 나머지는 S3의 Parquet 파일에서 직접 가져옵니다. 내부적으로 DuckDB는 Parquet 데이터의 분석 스캔을 처리하고, Aurora는 운영 데이터를 처리합니다. 이전에는 이 단일 쿼리를 실행하려면 먼저 과거 데이터를 데이터베이스로 이동하는 파이프라인이 필요했을 것입니다.
쿼리 패턴에 한 자릿수 밀리초의 지연 시간이 필요한 경우, 데이터 레이크의 데이터를 네이티브 Aurora PostgreSQL 테이블로 구체화할 때 사용할 수 있는 익숙한 명령으로는 CREATE TABLE AS SELECT, INSERT INTO ... SELECT, 또는 MERGE INTO 등이 있습니다. 구체화된 테이블은 Aurora에 저장되며 다른 PostgreSQL 테이블과 마찬가지로 쿼리할 수 있으므로, 별도의 수집 파이프라인을 운영하지 않고도 핫 데이터에 낮은 지연 시간으로 액세스할 수 있습니다. 읽기 쿼리는 라이터나 읽기 전용 복제본 등 클러스터의 모든 Aurora PostgreSQL 인스턴스에서 실행할 수 있으므로, 운영 워크로드에서 분석 스캔을 오프로드할 수 있습니다. 구체화 명령은 Aurora에 데이터를 쓰므로 라이터 인스턴스에서 실행됩니다.
지금 시작하기
Amazon Aurora PostgreSQL에서 Apache Iceberg 및 Parquet 데이터를 직접 쿼리하는 기능은 오늘부터 모든 상용 AWS 리전과 AWS GovCloud(US) 리전에서 추가 요금 없이 사용할 수 있습니다. 쿼리에 추가로 사용되는 Aurora 컴퓨팅 비용과 데이터 레이크 파일을 읽는 데 드는 Amazon S3 요청 비용만 지불하면 됩니다.
자세한 내용은 Amazon Aurora 기능 페이지를 방문하거나 Aurora PostgreSQL 설명서를 읽어보세요. 또는 Amazon RDS 콘솔에서 직접 사용해 보세요. AWS re:Post 또는 평소 연락하는 AWS Support 담당자를 통해 피드백을 보내주세요.