요약
多个团队共用一个 Kubernetes 集群,A 团队提交了一批训练任务,几十张 GPU 很快就被占满;B 团队新提交的 Job 只能一直 Pending。 因为,而是 Kubernetes 原生采用"先到先得"的调度方式,没有 Job 队列,也没有多租户配额管理。 Kueue 正是 Kuberne
본문
多个团队共用一个 Kubernetes 集群,A 团队提交了一批训练任务,几十张 GPU 很快就被占满;B 团队新提交的 Job 只能一直 Pending。
因为,而是 Kubernetes 原生采用"先到先得"的调度方式,没有 Job 队列,也没有多租户配额管理。
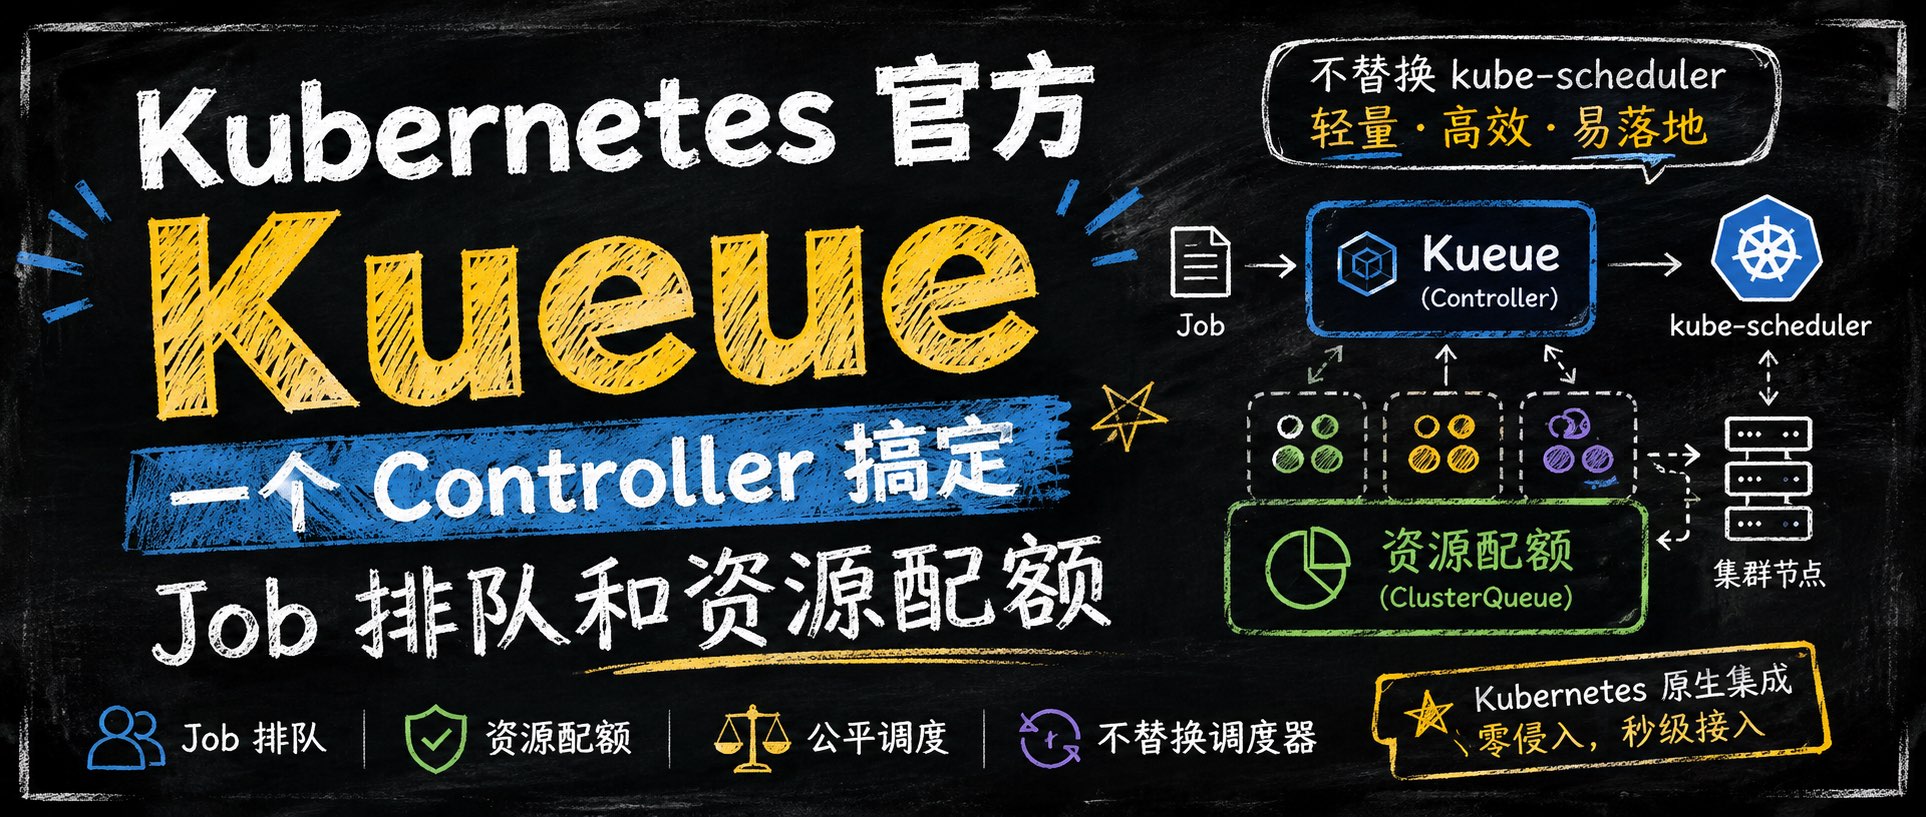
Kueue 正是 Kubernetes 官方为此提供的解决方案。它不替换 kube-scheduler,只负责 Job 的排队和准入,在此基础上实现资源配额管理和公平调度。
1. Kueue 简介
Kueue 是什么?
Kueue 是 Kubernetes SIGs 维护的官方 Job 级队列管理系统,负责决定 Job 何时准入(Admit)、何时被驱逐(Preempt),核心目标是管理资源配额和多租户公平调度。
和 Volcano 最大的区别:Kueue 不替换 kube-scheduler,它只管"排队和准入",调度还是交给原生调度器。
Volcano = 自定义调度器 + 队列管理 + 作业管理
Kueue = 队列管理 + 配额管理(调度交给 kube-scheduler)
Kueue 能做什么?
-
多租户配额管理:通过 ClusterQueue 为不同团队划分资源配额
-
公平调度:基于 Dominant Resource Shares(DRS)的公平共享算法,防止资源被单一团队长期独占
-
队列排队:Job 提交后按优先级排队,配额不足时挂起等待
-
Cohort 借调:同一 Cohort 内的 ClusterQueue 可以借用彼此空闲配额,用完归还
-
弹性配额:支持 nominalQuota(保底)+ borrowingLimit(借用上限)+ lendingLimit(出借上限)三层额度控制
-
标准兼容:原生支持 K8s Job / JobSet / PyTorchJob / TFJob / RayJob 等,无需改 Job YAML
为什么需要 Kueue?
或者说 Kueue 解决了什么原生 K8s 解决不了的问题?
原生 Kubernetes 的资源管理是"先到先得",没有队列的概念:
| 场景 | 原生 Kubernetes | Kueue | 优势 |
|---|---|---|---|
| 配额管理 | ResourceQuota 粗粒度控制 | ClusterQueue 细粒度配额(按 GPU 型号/节点池划分) | 精确到资源类型和 Flavor |
| 多租户公平 | 先到先得,无法保障公平 | Fair Sharing 基于 DRS 的公平分配 | 防止资源独占 |
| Job 排队 | Pending 后只能等 | 支持优先级队列、FIFO 策略 | 按优先级有序调度 |
| 跨团队借调 | 不支持 | Cohort 机制,空闲配额自动借出、按需归还 | 提高集群利用率 |
举一个典型场景:公司有两个 AI 团队共享一个 GPU 集群,各有 50% 的 A100 配额。团队 A 没任务时,团队 B 可以借用全部 GPU;团队 A 提交任务后,Kueue 会通过 preemption 让团队 B 释放借用的资源,回到公平状态。
原生 K8s 做不到这一点。
Kueue vs Volcano 快速对比
| 维度 | Kueue | Volcano |
|---|---|---|
| 定位 | 队列 + 配额管理(轻量) | 批处理调度平台(重量) |
| 架构 | 不替换调度器,旁路管理 | 自定义调度器,替换 kube-scheduler |
| 归属 | Kubernetes SIGs 官方 | CNCF(华为发起) |
| 部署复杂度 | 一个 Controller | Scheduler + Controller + Admission 三个组件 |
| Gang Scheduling | 通过 All-or-Nothing with Ready Pods(超时机制) | 原生 Gang Scheduling |
| Job API | 标准 K8s Job(自动创建 Workload) | 自定义 VolcanoJob(vcjob) |
更多参考:Kueue 官方文档、Volcano 系列文章
2. 核心概念
在部署之前,先理解 Kueue 的 5 个核心对象:
┌─────────────────────────────────────────────────────┐
│ Cohort │
│ ┌─────────────────┐ ┌─────────────────┐ │
│ │ ClusterQueue A │ │ ClusterQueue B │ │
│ │ (nominal: 5GPU) │ │ (nominal: 5GPU) │ │
│ │ borrowLimit: 5 │ │ borrowLimit: 5 │ │
│ └────────┬─────────┘ └────────┬─────────┘ │
│ │ │ │
│ ResourceFlavor: A100 / T4 / CPU │
└─────────────────────────────────────────────────────┘
 │ │
 LocalQueue A LocalQueue B ← Namespaced
 (team-a) (team-b)
 │ │
 Workload 1 Workload 2 ← 用户的 Job
-
ResourceFlavor:Flavor,代表不同类型的资源(如 A100 vs T4、Spot vs On-Demand),可以绑定 nodeLabels / taints
-
ClusterQueue:集群级队列,定义资源配额(nominalQuota / borrowingLimit / lendingLimit),是配额管理的核心
-
LocalQueue:命名空间级队列,用户直接和它打交道,指向一个 ClusterQueue
-
Cohort:ClusterQueue 的组,同组内可以互相借调空闲配额
-
Workload:Kueue 的调度单元,Kueue 会为每个 Job 自动创建对应的 Workload,用户一般不需要手动创建
调度流程
一个 Job 从提交到运行,经过 Kueue 的完整流程:
用户提交 Job (带 kueue.x-k8s.io/queue-name 标签)
 ↓
Kueue 自动创建 Workload 对象
 ↓
Workload 进入 LocalQueue → 找到对应的 ClusterQueue
 ↓
检查 ClusterQueue 是否有足够配额?(允许从 Cohort 借调)
 ├── 没有 → 询问 Cluster Autoscaler 能否扩容? → 等待扩容
 ↓ (有配额 或 扩容完成)
检查 ClusterQueue 是否配置了 AdmissionCheck?
 ├── 有 → 等待所有 Check 通过 → 最终准入
 └── 没有 → 直接最终准入
 ↓
Kueue 注入 nodeAffinity/tolerations (锁定算力)
 ↓
Job Controller 创建 Pod
 ↓
Kube Scheduler 分配 Pod 到具体节点
 ↓
节点资源不足? → 触发 Cluster Autoscaler 真正扩容节点 (Provision)

关键点:Kueue 只负责"准入"决策,Pod 真正调度到哪个节点还是 kube-scheduler 决定。
3. Kueue 部署
Kueue 部署非常轻量,只需要一个 Controller。
版本兼容性
Kueue 要求 Kubernetes 1.29+,本文使用 Kubernetes v1.36.1 部署最新的 Kueue v0.18.1。
安装
官方提供了两种安装方式,推荐 Helm:
方式一:kubectl 直接安装
kubectl apply --server-side -f https://github.com/kubernetes-sigs/kueue/releases/download/v0.18.1/manifests.yaml
方式二:Helm 安装(推荐)
helm install kueue oci://registry.k8s.io/kueue/charts/kueue \
 --version=0.18.1 \
 --namespace kueue-system \
 --create-namespace \
 --wait --timeout 300s
无法访问
registry.k8s.io可以从 GitHub 下载 chart 包安装:helm install kueue https://github.com/kubernetes-sigs/kueue/releases/download/v0.18.1/kueue-0.18.1.tgz \ --namespace kueue-system \ --create-namespace \ --wait --timeout 300s
卸载
helm uninstall kueue --namespace kueue-system
验证
kubectl -n kueue-system get po
NAME READY STATUS RESTARTS AGE
kueue-controller-manager-665fc6d58-whxcz 1/1 Running 0 60m
一个 Pod 就搞定了,这就是 Kueue 轻量的地方。
4. 快速上手:一个完整的 Demo
接下来我们跑一个最小化 Demo:创建 ResourceFlavor → ClusterQueue → LocalQueue → 提交 Job,完整走一遍 Kueue 的工作流程。
4.1 创建基础资源
Kueue 使用三种资源来管理作业排队:
- ResourceFlavor:描述作业可用的硬件配置
- ClusterQueue:定义资源池的配额(CPU、内存等)
- LocalQueue:用户提交作业的命名空间级队列,映射到 ClusterQueue
apiVersion: kueue.x-k8s.io/v1beta2
kind: ResourceFlavor
metadata:
 name: "default-flavor"
---
apiVersion: kueue.x-k8s.io/v1beta2
kind: ClusterQueue
metadata:
 name: "cluster-queue"
spec:
 namespaceSelector: {} # 允许所有命名空间
 resourceGroups:
 - coveredResources: ["cpu", "memory"]
 flavors:
 - name: "default-flavor"
 resources:
 - name: "cpu"
 nominalQuota: 9
 - name: "memory"
 nominalQuota: 9Gi
---
apiVersion: kueue.x-k8s.io/v1beta2
kind: LocalQueue
metadata:
 namespace: "default"
 name: "user-queue"
spec:
 clusterQueue: "cluster-queue"
kubectl apply -f queue.yaml
4.2 验证队列状态
# ClusterQueue 是否激活
kubectl get clusterqueue cluster-queue -o wide

# LocalQueue 是否就绪
kubectl get localqueue user-queue -n default
root@lixd-dev-4:~# kubectl get clusterqueue cluster-queue -o wide
NAME COHORT STRATEGY PENDING WORKLOADS ADMITTED WORKLOADS
cluster-queue BestEffortFIFO 0 0

root@lixd-dev-4:~# kubectl get localqueue user-queue -n default
NAME CLUSTERQUEUE PENDING WORKLOADS ADMITTED WORKLOADS
user-queue cluster-queue 0 0
队列创建成功,当前没有 Workload。
4.3 提交 Job
注意看,这里用的就是标准的 K8s Job,只需要加一个 label 就能接入 Kueue:
apiVersion: batch/v1
kind: Job
metadata:
 name: sample-job
 namespace: default
 labels:
 kueue.x-k8s.io/queue-name: user-queue # 接入 Kueue 的关键
spec:
 parallelism: 3
 completions: 3
 template:
 spec:
 containers:
 - name: dummy-job
 image: registry.k8s.io/e2e-test-images/agnhost:2.53
 command: ["/bin/sh"]
 args: ["-c", "sleep 30"]
 resources:
 requests:
 cpu: "1"
 memory: "200Mi"
 restartPolicy: Never
kubectl apply -f job.yaml
4.4 验证
# 查看 Kueue 自动创建的 Workload
kubectl get workloads -n default

# 查看 Pod
kubectl get pods -n default
root@lixd-dev-4:~# kubectl get workloads -n default
NAME QUEUE RESERVED IN ADMITTED FINISHED AGE
job-sample-job-555d8 user-queue cluster-queue True 9s

root@lixd-dev-4:~# kubectl get pods -n default
NAME READY STATUS RESTARTS AGE
sample-job-j6xdp 1/1 Running 0 14s
sample-job-k4mtm 1/1 Running 0 14s
sample-job-nvjkz 1/1 Running 0 14s
可以看到 Kueue 自动为 Job 创建了对应的 Workload,Workload 状态为 Admitted(已准入),3 个 Pod 正常运行。
4.5 等待任务完成
# 等待任务完成
kubectl get jobs -n default -w
root@lixd-dev-4:~# kubectl get jobs -n default -w
NAME STATUS COMPLETIONS DURATION AGE
sample-job Complete 3/3 34s 44s
Job 完成后,Workload 也会被标记为 Finished:
kubectl get workloads -n default
root@lixd-dev-4:~# kubectl get workloads -n default
NAME QUEUE RESERVED IN ADMITTED FINISHED AGE
job-sample-job-555d8 user-queue cluster-queue True True 49s
到这里,我们完整走了一遍 Kueue 的工作流程:创建队列 → 提交 Job → Kueue 自动准入 → Pod 运行 → 任务完成。
整个过程中,我们用的是标准的 K8s Job,唯一的变化就是加了一个 kueue.x-k8s.io/queue-name 标签。这就是 Kueue "不替换调度器、旁路管理"设计哲学的体现。
5. 小结
Kueue 是 Kubernetes SIGs 官方出品的 Job 队列与配额管理系统,它的核心设计哲学是"只管排队和准入,不动调度器",这让它非常轻量且对现有集群侵入性极小。
本文介绍了 Kueue 的背景、核心概念和部署方式,并通过一个最小化 Demo 走完了"创建队列 → 提交 Job → 自动准入 → 任务完成"的完整流程。
下一篇我们将深入解析 Kueue 的五大核心对象(ResourceFlavor / ClusterQueue / LocalQueue / Cohort / Workload),搞清楚它们各自的职责和配置细节。